 lzz's Blog
Qdrant
第一章 概述
1.1 Qdrant 简介
1.1.1 Qdrant 简介
向量数据库是一种相对较新的交互方式,用于处理源自不透明机器学习模型(如深度学习架构)的抽象数据表示。这些表示通常被称为向量(vectors)或嵌入(embeddings)。
Qdrant 是一个向量相似度搜索引擎,提供生产就绪的服务,并配备了便捷的 API,用于存储、搜索和管理带有额外负载(payload)的点(即向量)。可以将负载视为额外的信息片段,它们可以帮助你优化搜索,并提供可呈现给用户的有用信息。
1.1.2 向量数据库
向量数据库是一种专门用于高效存储和查询高维向量的数据库。
- 在传统的 OLTP 和 OLAP 数据库中,数据以行和列的形式组织(称为表),查询是基于这些列中的值进行的。
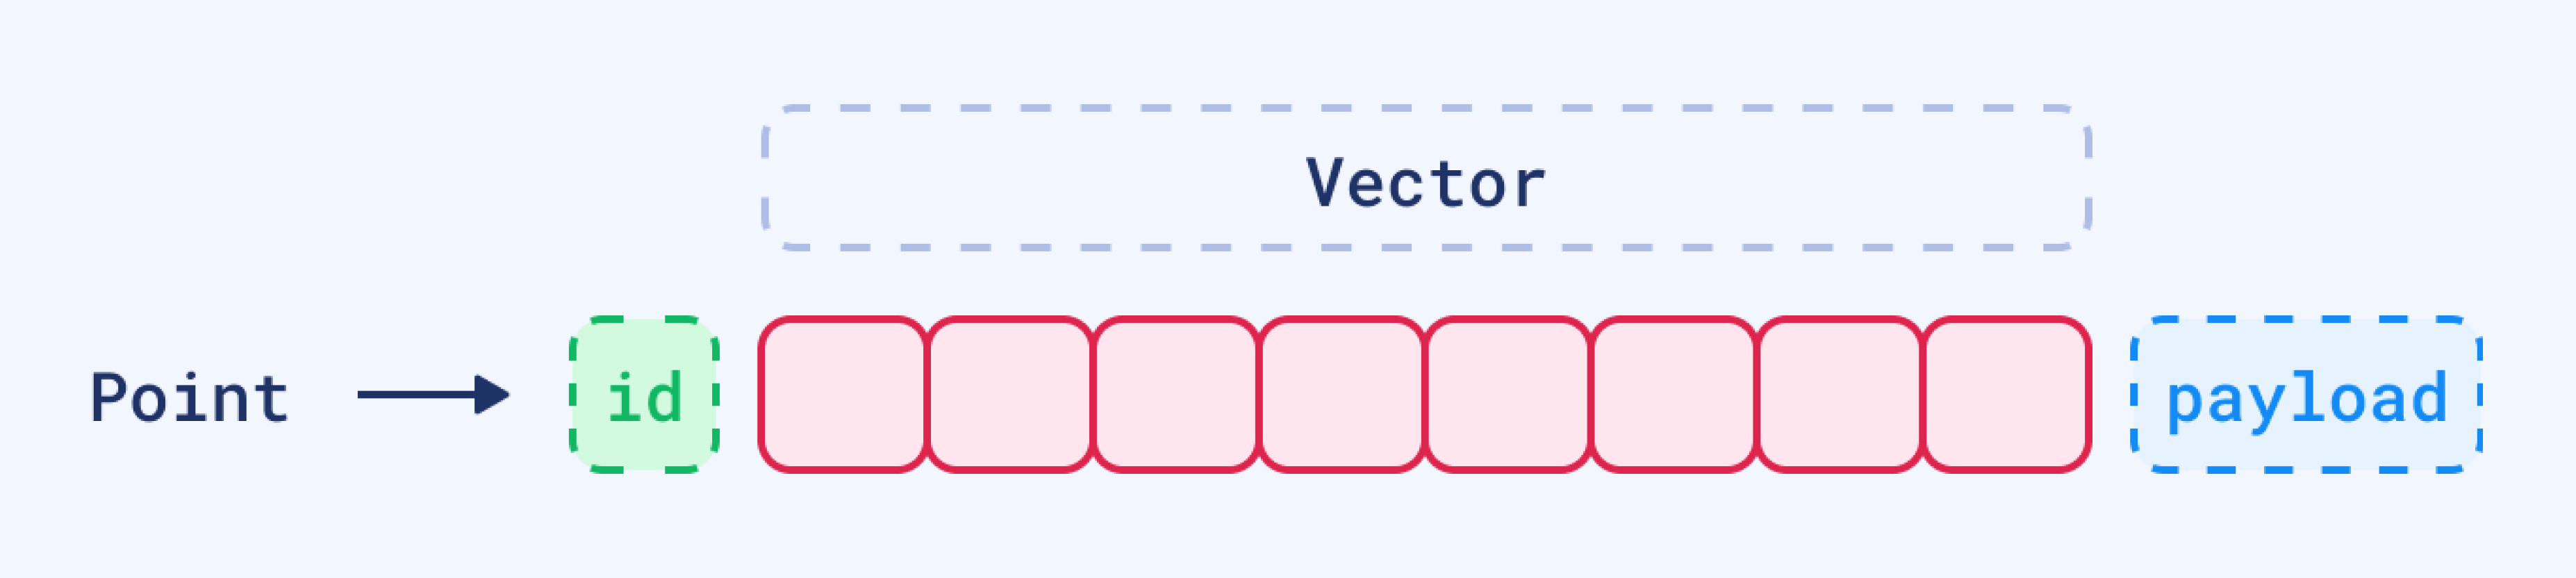
- 在图像识别、自然语言处理和推荐系统等特定应用中,数据通常表示为高维空间中的向量。这些向量加上 ID 和负载,我们称之为“点”(Point)。这些点就是我们在 Qdrant 等向量数据库中称为集合(Collection)的结构中存储的元素。
在此语境下,向量是对象或数据点的数学表示,向量的元素隐含或显式地对应于对象的特定特征或属性。
向量数据库针对这些高维向量的存储和查询进行了优化,它们通常使用专门的数据结构和索引技术,例如层次化可导航小世界图(HNSW,用于实现近似最近邻搜索)和乘积量化(Product Quantization)等。这些数据库支持快速的相似度和语义搜索,允许用户基于某种距离度量找到最接近给定查询向量的向量。最常用的距离度量包括欧几里得距离、余弦相似度和点积,Qdrant 完全支持这三种度量。
- 余弦相似度 - 余弦相似度是一种衡量两个向量相似程度的方法。简单来说,它反映了向量是否具有相同的方向(相似)或截然相反。余弦相似度的输出范围为 -1 到 1,其中 -1 表示两个向量完全不相似,1 表示最大相似度。
- 点积 - 点积相似度度量是另一种衡量两个向量相似度的方法。与余弦相似度不同,它还考虑了向量的长度。例如,当文档的向量表示是基于术语(词)频率构建时,这一点可能很重要。点积相似度通过将两个向量中的对应值相乘然后对这些乘积求和来计算。总和越高,两个向量越相似。如果对向量进行归一化(即让其中的数值之和为 1),点积相似度就等同于余弦相似度。
- 欧几里得距离 - 欧几里得距离是衡量空间中两点之间距离的一种方法。它是通过计算两个点坐标之间差值的平方和的平方根来得出的。这种距离度量在机器学习中也常用于衡量两个向量的相似或不相似程度。
向量数据库的必要性
向量数据库在需要相似度搜索的各种应用中起着至关重要的作用,如推荐系统、基于内容的图像检索和个性化搜索。通过利用其高效的索引和搜索技术,向量数据库能够更快、更准确地检索已表示为向量的非结构化数据,从而帮助用户获得与其查询最相关的结果。
此外,使用向量数据库的其他好处还包括:
- 高效存储和索引高维数据。
- 能够处理拥有数十亿数据点的大规模数据集。
- 支持实时分析和查询。
- 能够处理源自复杂数据类型(如图像、视频和自然语言文本)的向量。
- 提高了机器学习和 AI 应用的性能并降低了延迟。
- 与构建定制解决方案相比,减少了开发和部署的时间与成本。
1.1.3 Qdrant 高级概述
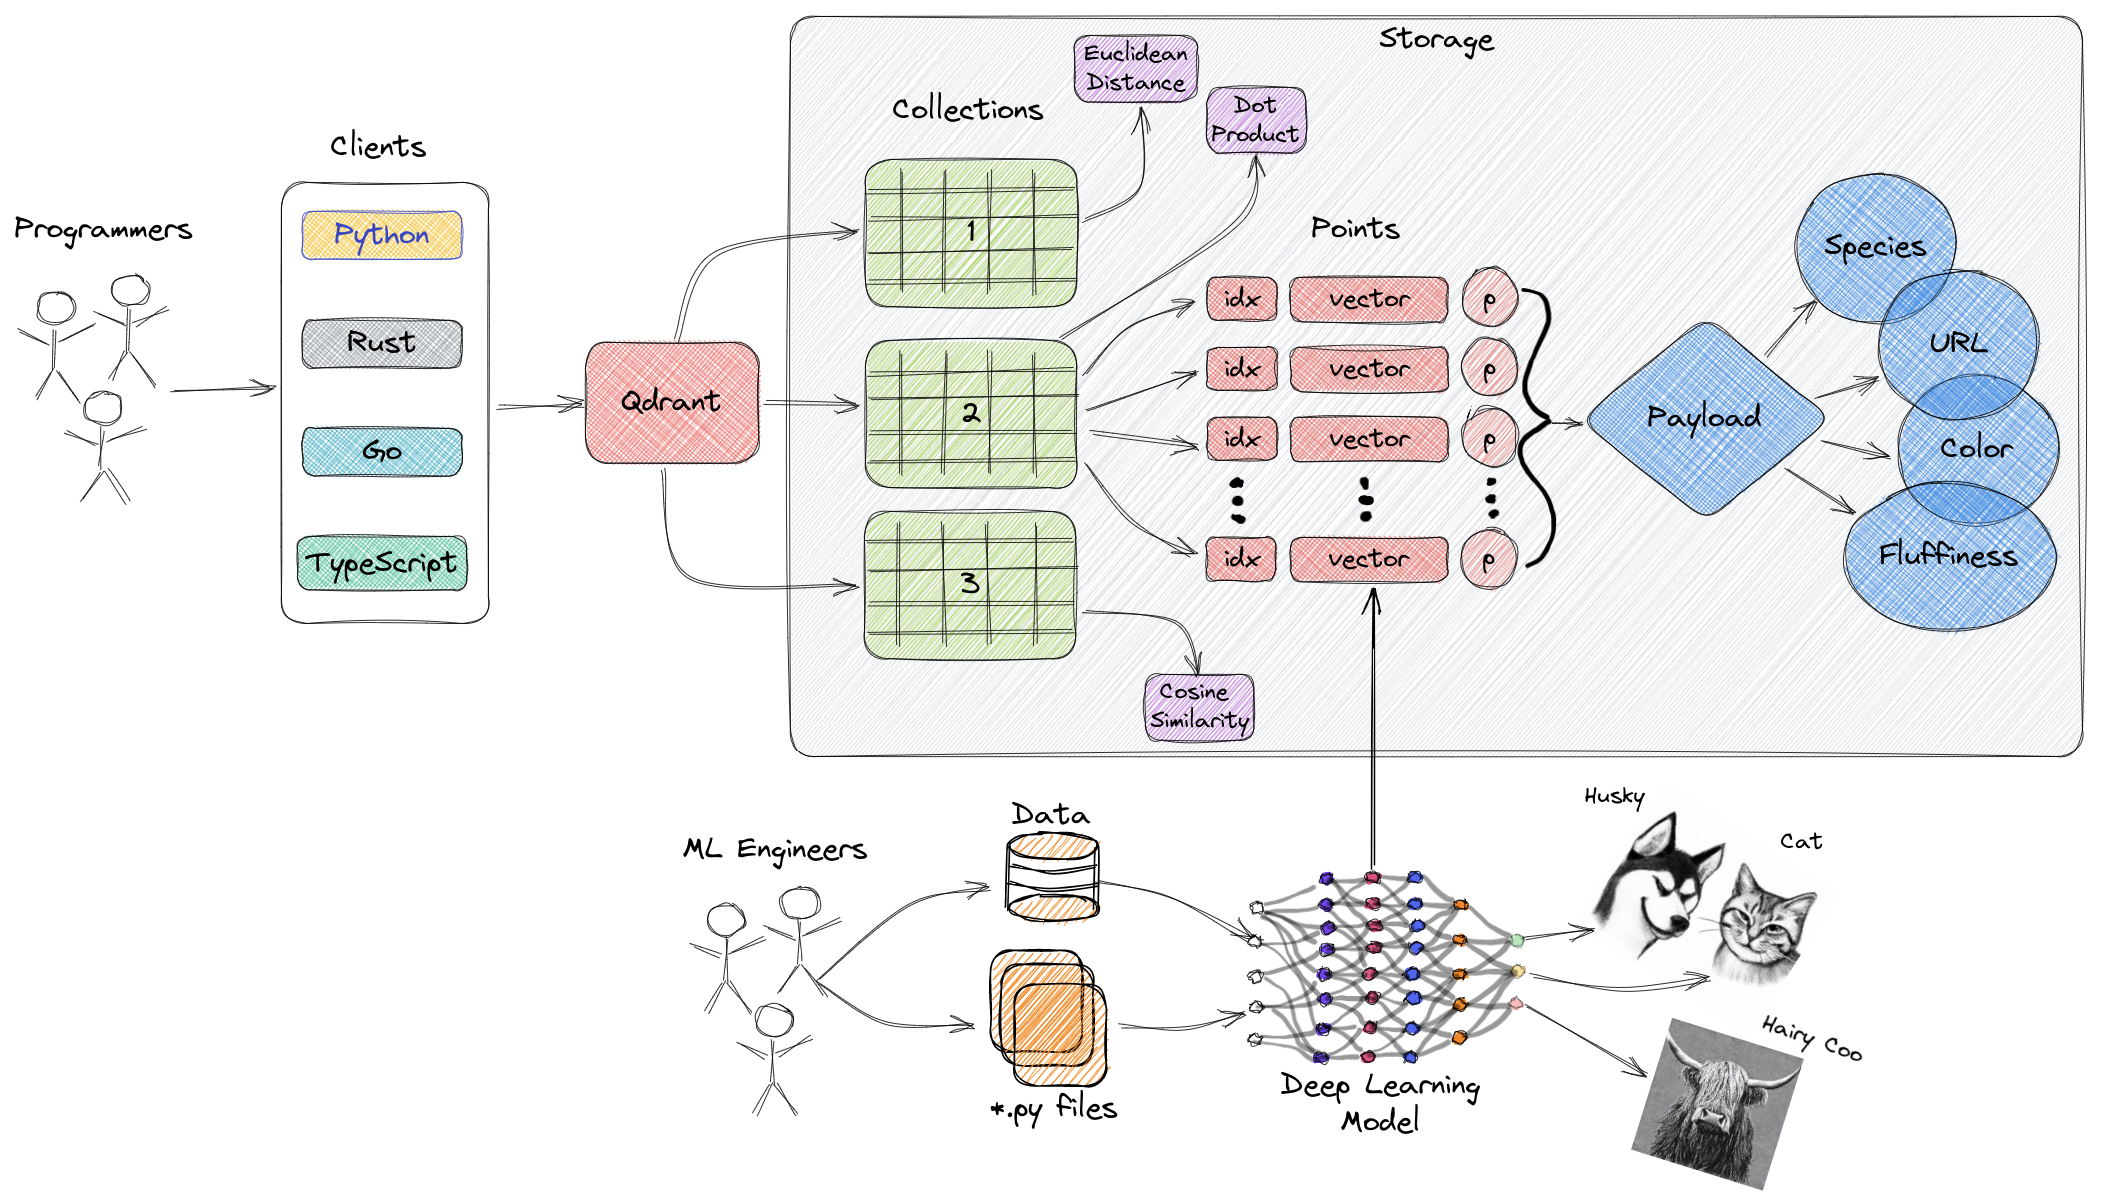
- 集合(collections):集合是一组已命名的点(带有有效载荷的向量),可以在其中进行搜索。同一集合中每个点的向量必须具有相同的维度,并且使用同一个指标进行比较。命名向量(Named vectors)允许在单个点中包含多个向量,每个向量可以有自己的维度和指标要求。
- 距离度量(Distance Metrics):这些度量用于衡量向量之间的相似性,必须在创建集合时同时选择。度量的选择取决于向量的获取方式,尤其取决于将用于编码新查询的神经网络。
- 点:点是 Qdrant 操作的核心实体,由向量、可选的 ID 和有效载荷组成。
- id:向量的唯一标识符。
- 向量:数据的高维表示,例如图像、声音、文档、视频等。
- 有效载荷:有效载荷是一个 JSON 对象,其中包含您可以添加到向量中的附加数据。
- 存储:Qdrant 将数据持久化到磁盘,并允许选择有多少数据也驻留在内存中:
pinned将热数据完全保留在 RAM 中,cached以实现热磁盘缓存,或者cold在处理大型数据集时节省 RAM。 - 客户端:可用于连接到 Qdrant 的编程语言。
1.2 向量搜索
1.2.1 搜索概述
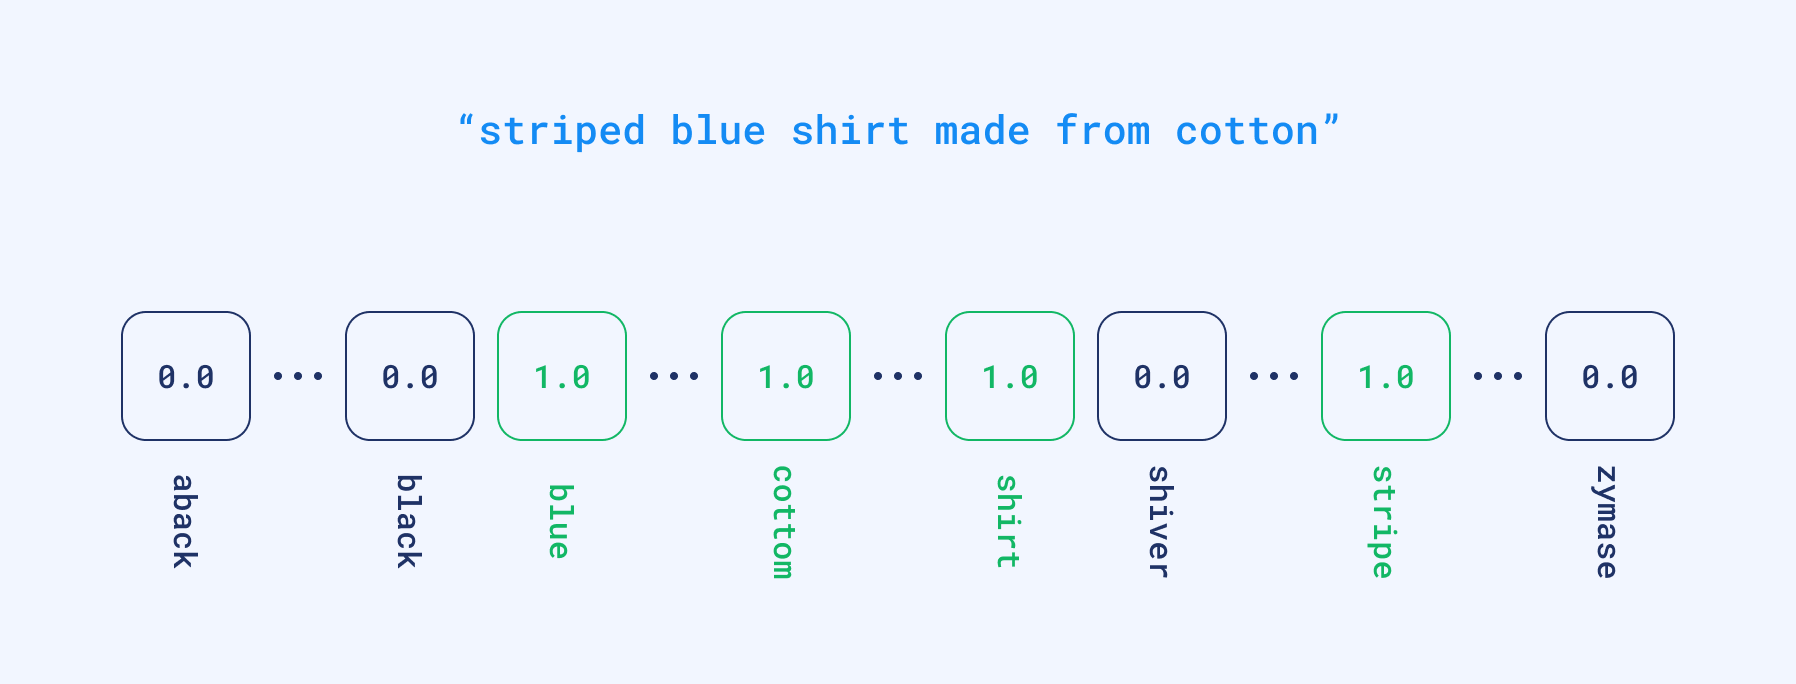
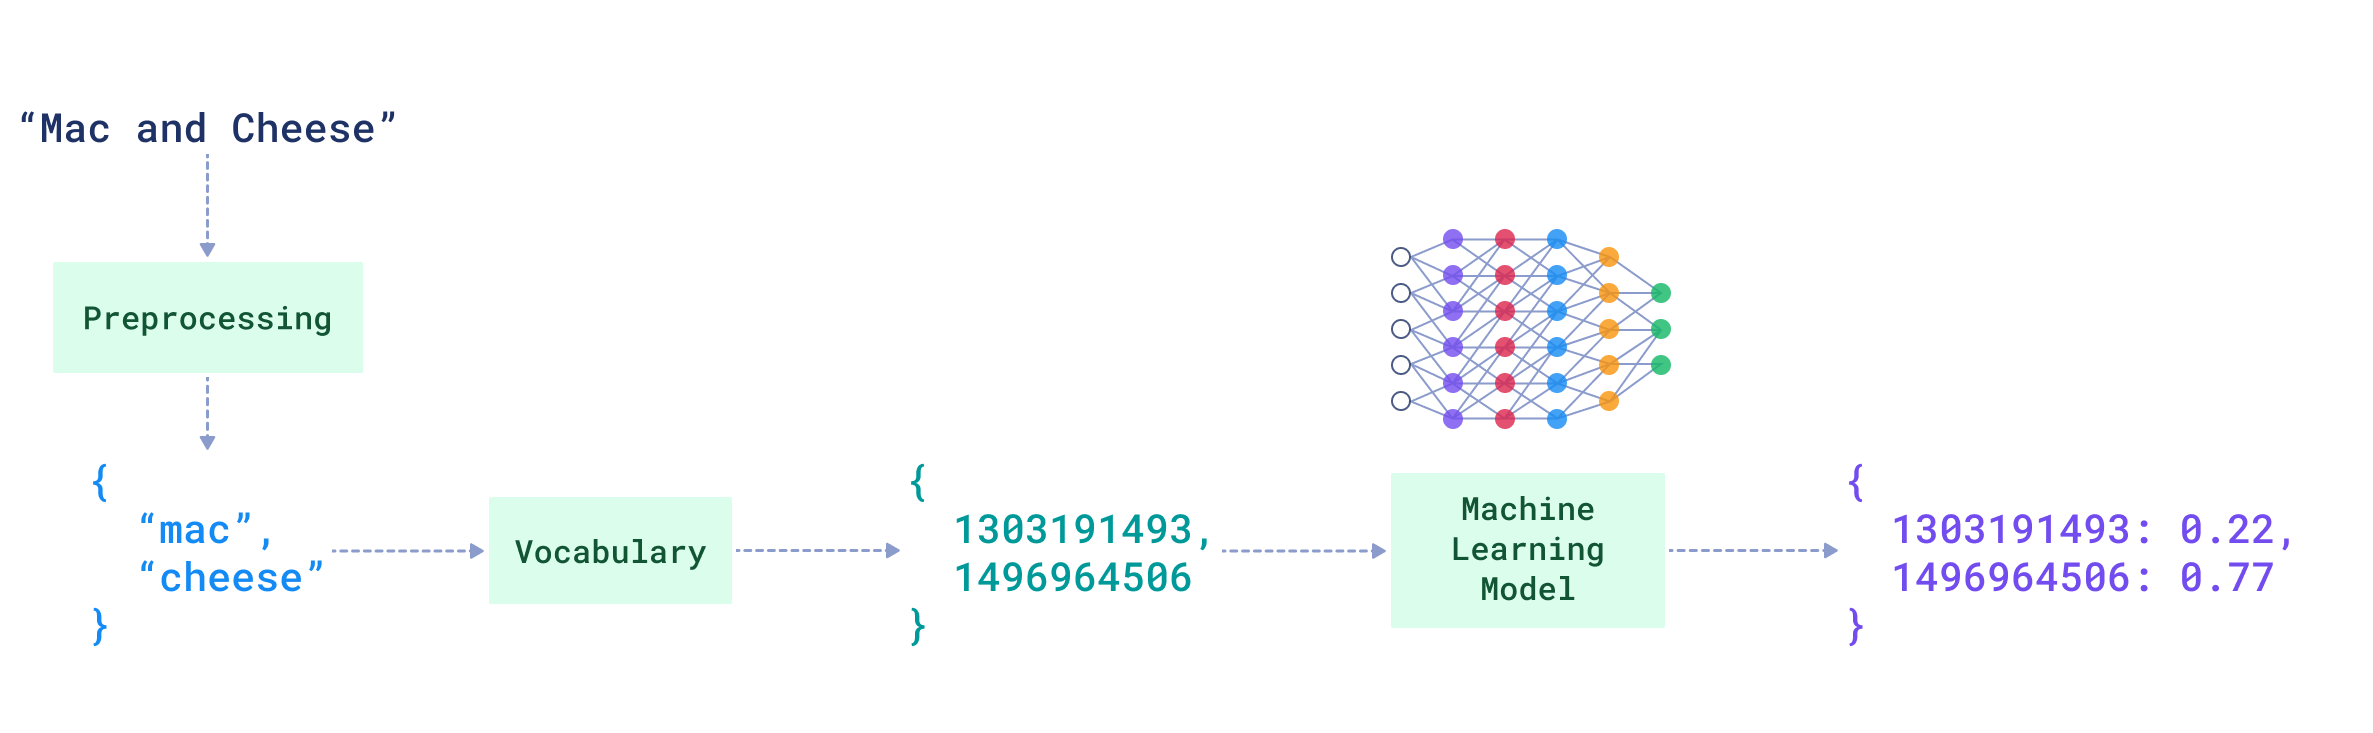
我们将文档和查询编码(以词典为例,如上图所示)为所谓的“稀疏向量”(sparse vectors),其中每个位置对应整个词典中的一个单词。如果输入文本包含特定单词,则该位置的值为非零。但实际上,没有任何文本会包含数千个不同的单词。因此,大多数向量会有数千个零和几个非零值。这就是为什么我们称它们为“稀疏”的。它们可以用来通过寻找重合度最大的文档来计算某种基于单词的相似度。
稀疏向量具有相对高维性;等于词典的大小。而词典是从输入数据中自动获取的。因此,如果我们有一个向量,我们能够部分重构用于创建该向量的文本中所使用的单词。
巴别塔问题
每隔一段时间,当我们发现倒排索引(类似字典,上述的稀疏向量就是其演进而来)的新问题时,我们就会提出一种新的启发式方法来在一定程度上解决它。当我们意识到人们可能会用不同的词来描述同一个概念时,我们开始建立同义词列表,将查询转换为规范形式。但这对于我们未预见到的情况并不奏效。我们仍然需要手工制作和维护字典,以便支持随时间变化的语言。多语言场景带来了另一个难题。旧方法需要设置单独的管道,并依靠人工来保持质量。
表征革命
机器学习在 NLP 领域的最新研究重点是训练深度语言模型。在这个过程中,神经网络将大量的文本语料库作为输入,并以向量的形式创建单词的数学表征。这些向量的创建方式是:含义相似且在相似上下文中出现的单词会被归为一类,并由相似的向量表示。我们还可以取所有单词向量的平均值来创建整个文本(例如查询、句子或段落)的向量。
我们可以获取网络产生的这些密集向量(dense vectors),并将其用作不同的数据表征。它们之所以密集,是因为神经网络很少在任何位置产生零。与稀疏向量相反,它们具有相对较低的维度——仅数百或数千个。
大型语言模型可以自动处理同义词。更重要的是,由于这些神经网络可能是在多语言语料库上训练的,它们将用不同语言编写的相同句子翻译成相似的向量表征,也称为嵌入(embeddings)。
向量搜索是基于嵌入相似性寻找相似对象的过程。
1.2.2 Qdrant 向量搜索流程
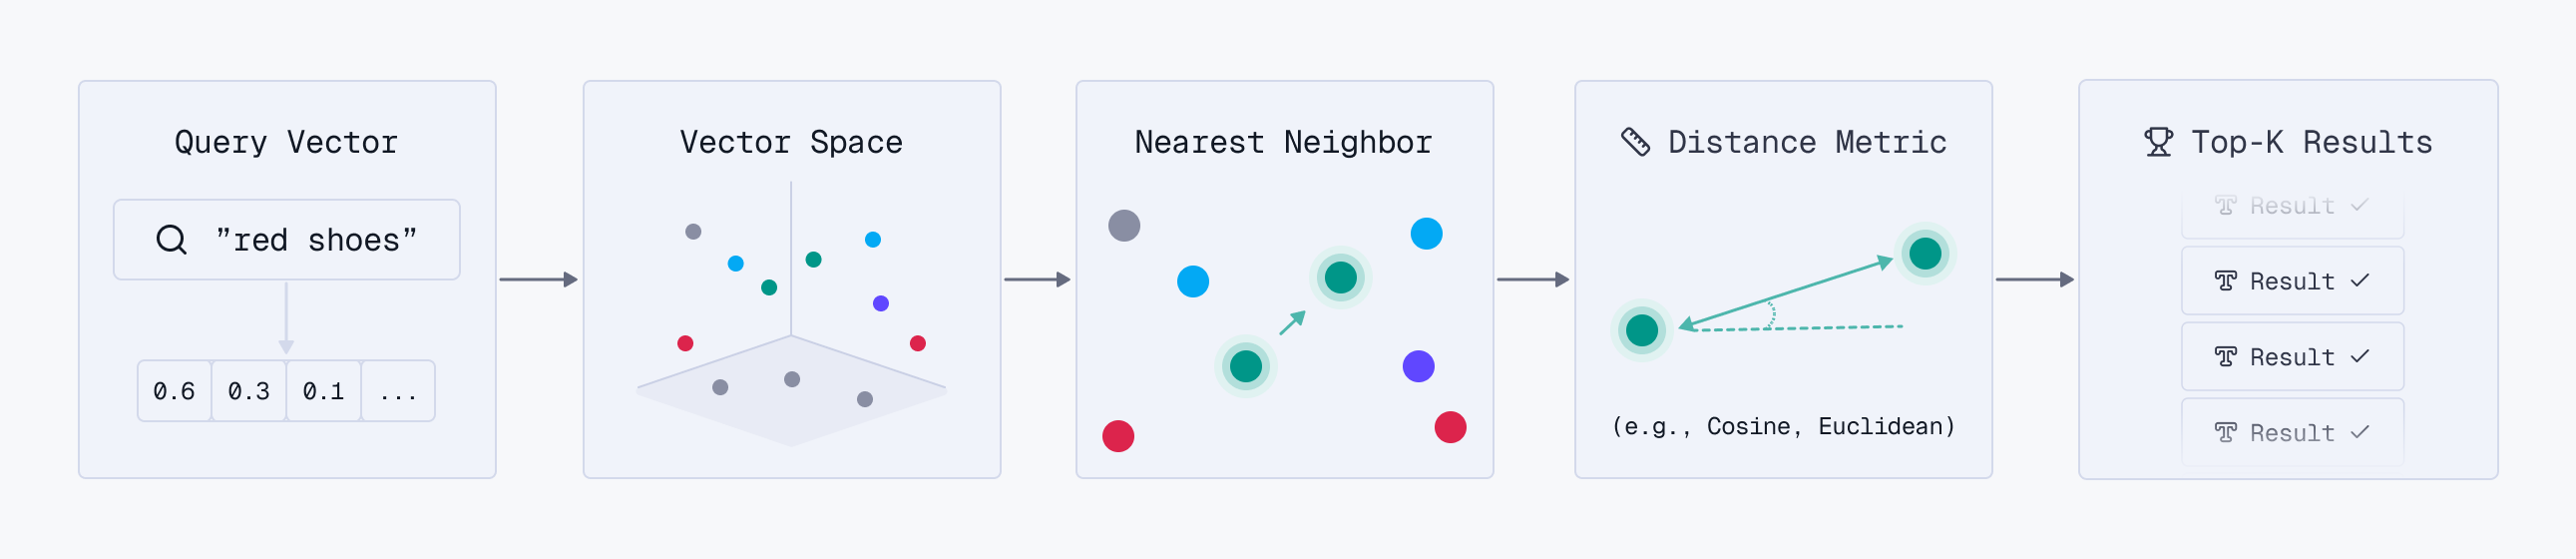
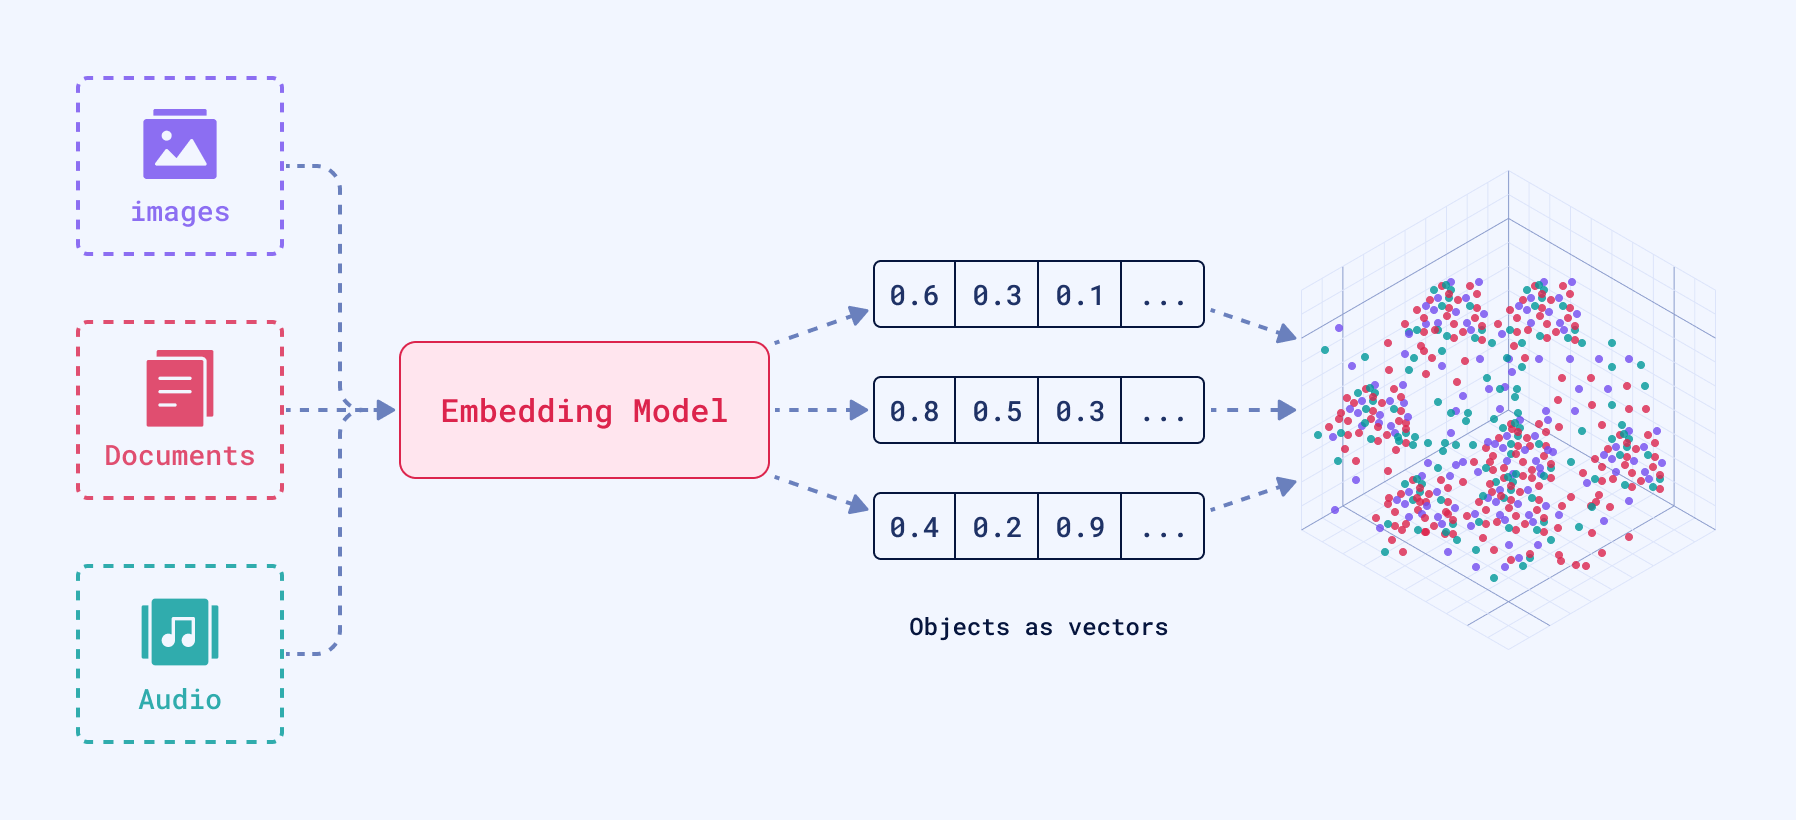
向量搜索是一种革命性的信息检索技术,它超越了关键字匹配,能够根据语义查找数据。它始于嵌入模型(embedding models),将非结构化数据(文本、图像、音频)转换为稠密向量嵌入(dense vector embeddings)——即代表数据概念本质的定长数字列表。这些向量被映射到一个高维的向量空间(vector space)中,语义相似的项目在空间中彼此靠近。
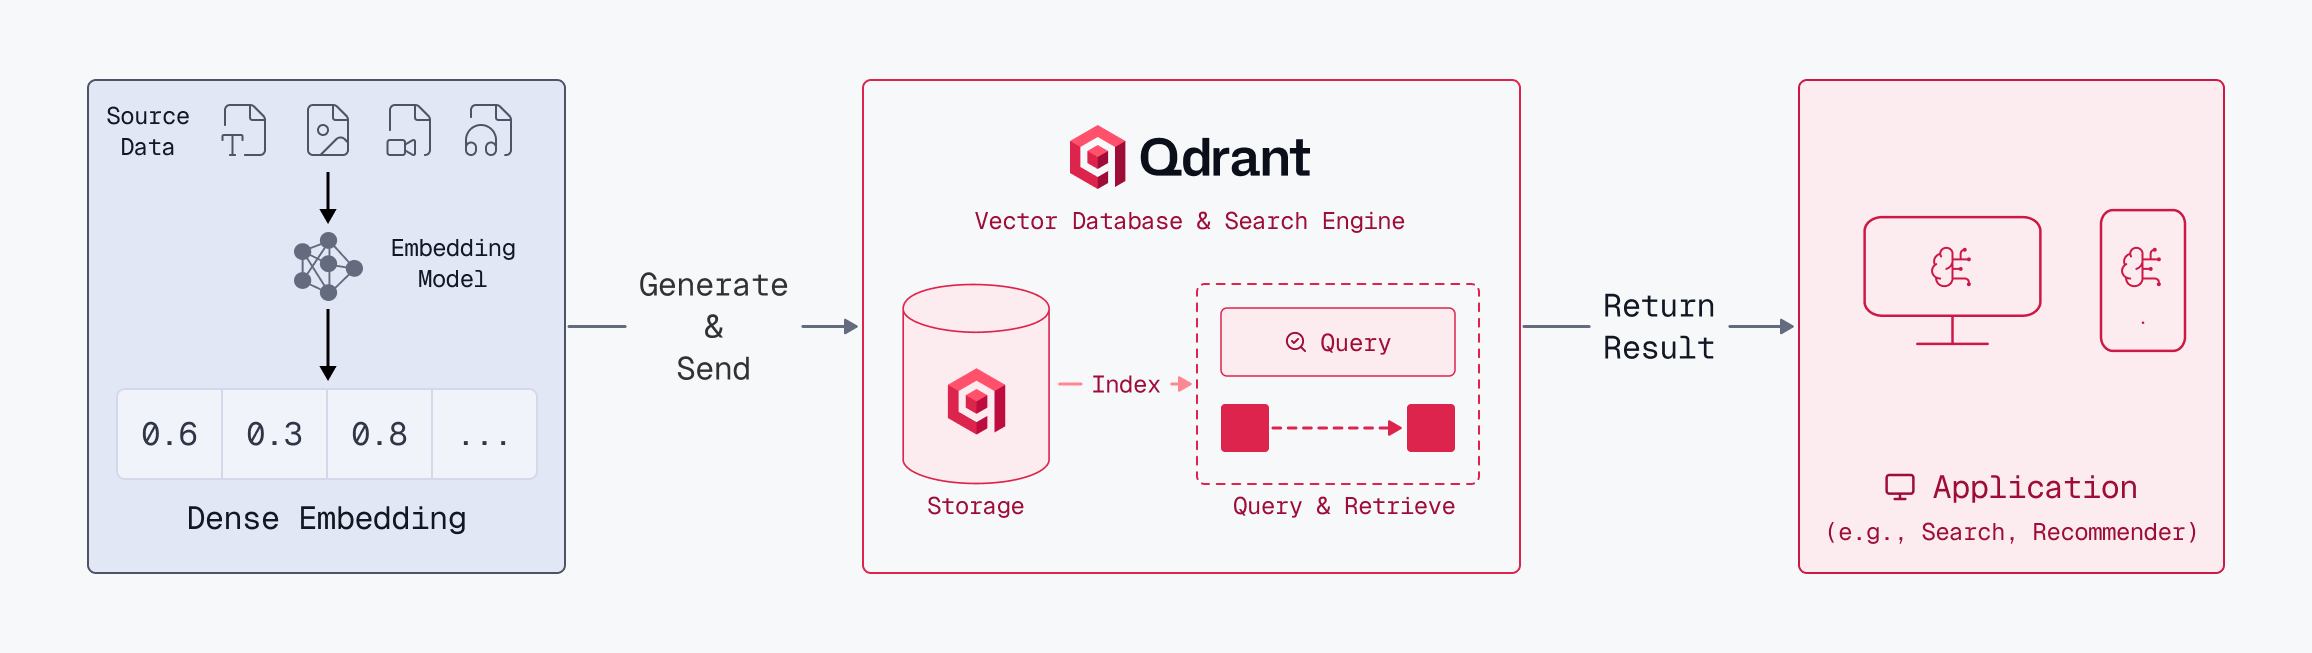
虽然密集向量在捕捉上下文方面表现出色,但有时会遗漏特定的技术术语或唯一标识符。为了弥补这一不足,Qdrant 还采用了稀疏向量,旨在捕捉特定关键词的精确词汇匹配。
从非结构化数据生成嵌入的过程称为推理(inference)。在 Qdrant Cloud 上,可以使用云推理(Cloud Inference)让 Qdrant 在服务器端生成嵌入。或者,使用 FastEmbed 等库在客户端生成嵌入。
搜索过程的核心在于Top-K检索的概念。当用户提交请求时,请求会立即被转换为查询向量。引擎随后计算该查询向量与文档向量之间的相似度,并返回“Top-K”个最接近的匹配项,其中 K 是用户自定义的数字,代表所需的搜索结果数量。这使得开发者能够微调搜索范围和结果精确度之间的平衡。
1.3 规模化考量
进行概念验证 (POC) 或个人项目时,Qdrant 的默认配置是合理的。然而,当项目过渡到生产环境并面临数据量和并发用户数的增长时,对高可用性、延迟或吞吐量的预期也会随之改变。
(1)内存要求
默认情况下,Qdrant 将向量存储在 RAM 中以实现最佳搜索性能,但随着集合增长到数百万个向量,将所有数据都保存在内存中会变得非常耗费资源。Qdrant 允许通过将数据卸载到磁盘来控制内存使用:
- 如果将向量存储在磁盘上,则经常访问的向量自然会保留在缓存中,而其他向量仅在需要时才从磁盘读取。
- 如果将 HNSW 索引存储在磁盘上,则图遍历可能需要 I/O 操作。
仅当内存严重不足时才将两者都放在磁盘上,并确保使用快速的 NVMe 存储。
(2)筛选(Filtering)
Qdrant 中每条数据由两部分组成:
- 向量:用于判断内容在语义上是否相似。
- Payload(有效载荷):保存价格、分类、时间、用户 ID、库存状态等普通属性。
仅靠向量搜索无法准确处理价格、日期等明确条件,因此需要使用 Payload 筛选。
例如:
搜索语义上与“跑鞋”相似,并且价格不超过 500 元、有库存的商品。
Qdrant 会在符合筛选条件的数据中,返回向量最相似的结果。
(3)载荷索引(payload indexes)
Payload 索引类似数据库字段索引,可以加快筛选速度:
- 没有索引:可能需要逐条检查数据。
- 建立索引:可以快速找到满足条件的数据。
- 通常应为经常参与筛选的字段建立索引,例如
price、category和user_id。
载荷索引的一个独特之处在于它扩展了 HNSW 图,允许在语义搜索阶段应用过滤条件。这意味着它是单次遍历图形,而不是预过滤或后过滤,这两种过滤方式都有各自的缺陷。
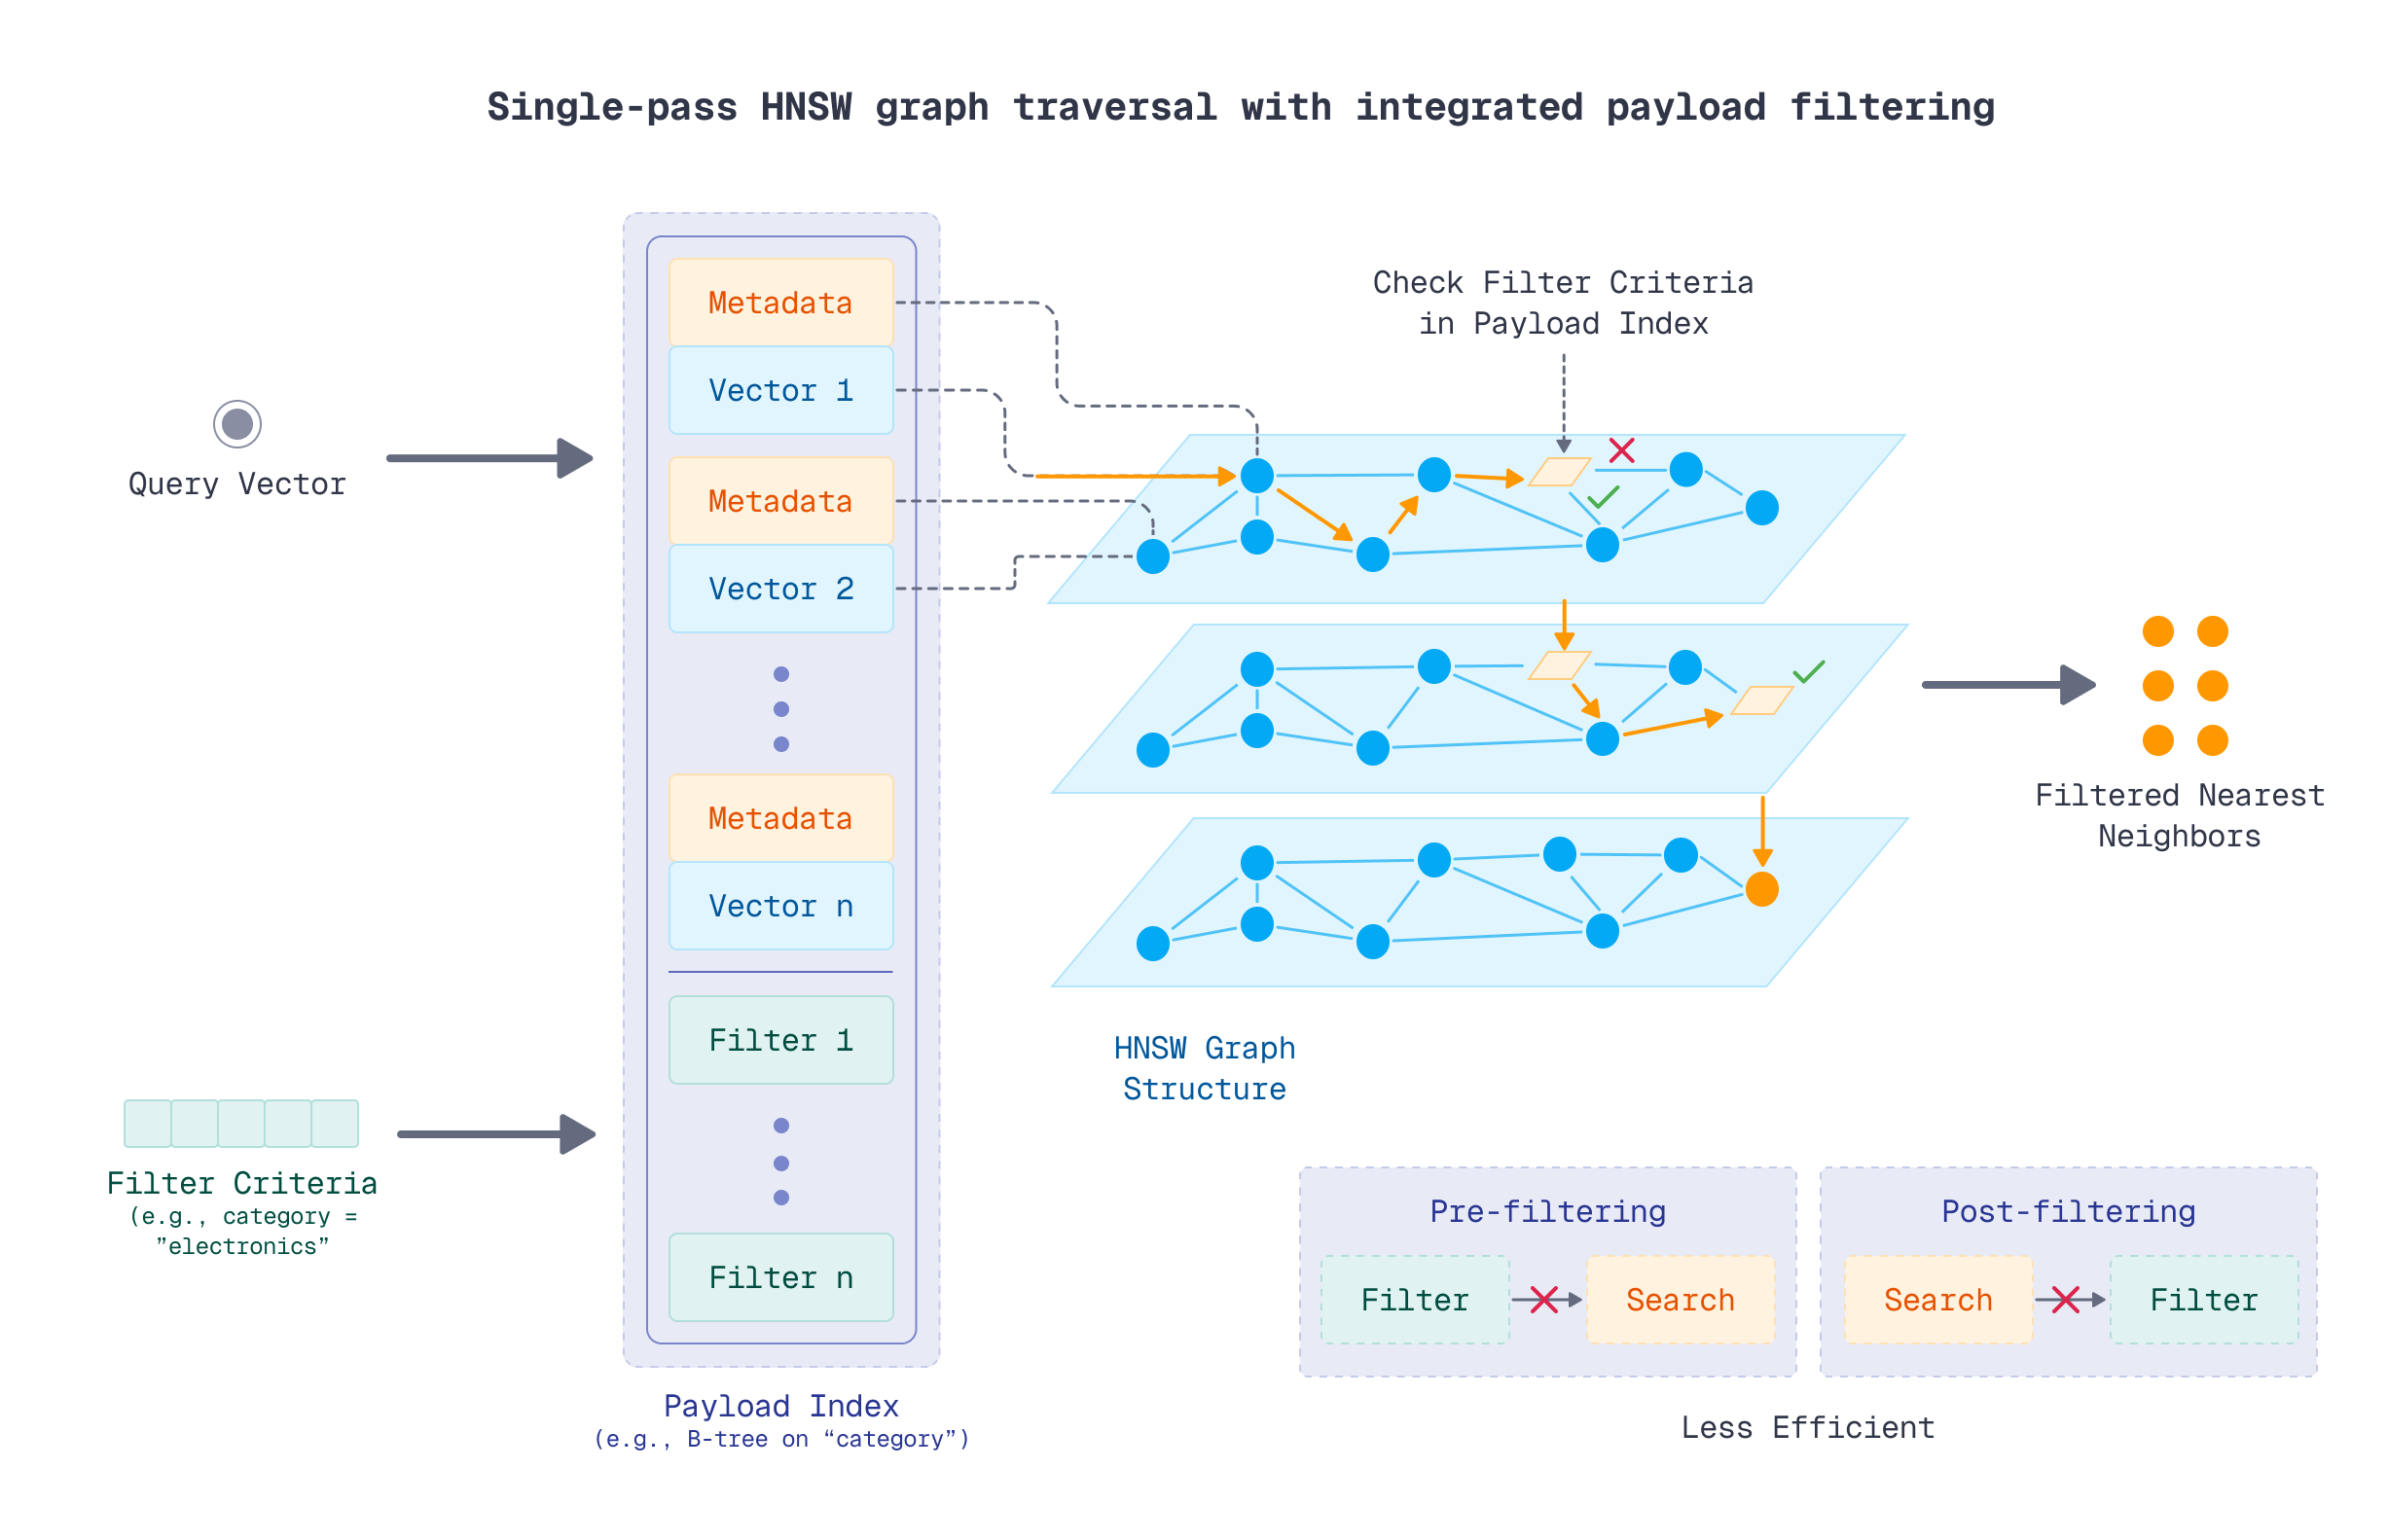
HNSW 图只有在优化器运行段重建时才会创建,这可以通过修改 HNSW 参数触发,例如暂时将 m 设置为 0,然后再改回原始值(默认 m=16)。
(4)规模化
纵向扩展存在天然局限——最终您会达到可用硬件的最大容量,且单节点部署缺乏冗余。通过分片(sharding)、复制(replication)和段配置(segment configuration)选项来优化扩展。
分片(sharding):Qdrant 使用分片将集合分散到多个节点上,其中每个分片都是独立的点存储区。通常建议从 12 个分片开始,这提供了从 1 个节点扩展到 2、3、6 或 12 个节点的灵活性,而无需重分片。然而,这种方法可能会限制小集群的吞吐量,因为每个节点需要管理多个分片。
为了获得最佳吞吐量,将
shard_number设置为等于您的节点数量(点击此处了解更多信息)。如果您希望更好地控制分片,Qdrant 支持自定义分片。复制(replication):复制因子决定了每个分片存在多少个副本。对于生产系统,强烈建议复制因子至少为 2。
段配置(segment configuration):每个分片将数据存储在多个段(segments)中。一个段存储分片中部分点的所有数据结构。
- 段数量越少,产生的段越大,搜索吞吐量越好,因为更大的 HNSW 索引需要较少的比较。
- 更大的段构建和重建需要更长时间,会减慢写入和优化速度。段数量越多意味着索引速度越快,但搜索性能较低,因为查询需要扫描更多的段。
(5)安全
某些集合级操作可能会降低 Qdrant 集群的性能。Qdrant 的严格模式通过多种控制措施来防止低效的使用模式:它可以阻止对未建立索引的有效负载字段进行过滤和更新,限制查询结果的大小和超时时间,限制过滤条件的复杂性和数量,限制有效负载索引的数量,限制批量更新插入操作的大小,强制执行最大集合存储限制(针对向量、有效负载和点计数),并对读写操作实施速率限制以防止系统过载。
Qdrant Cloud 默认禁用对未建立索引的有效负载属性进行过滤和更新,并将有效负载索引的最大数量限制为 100。如果您需要对未建立索引的有效负载属性执行一些一次性查询,可以考虑暂时禁用此功能,但通常情况下您不需要这样做。
1.4 Qdrant 快速上手
1.4.1 创建 Qdrant Cluster
Qdrant官网创建一个cluster,保留好 Apikey 和 Endpoint。
1.4.2 代码快速开始
1 | from qdrant_client import QdrantClient, models |
第二章 向量搜索基础
2.1 点、向量和负载
2.1.1 点(points):核心实体
点是 Qdrant 操作的核心实体。一个点是由三个部分组成的记录:
- 唯一 ID(64 位无符号整数或 UUID(未提供时生成UUID作为ID))
- 向量(稠密向量、稀疏向量或多向量)
- 可选载荷(元数据)
2.1.2 向量
2.1.2.1 向量类型
(1)稠密向量
稠密向量(Dense vectors)是向量搜索中最常用的向量表示,由大多数嵌入模型生成,用于捕捉数据中的本质模式或关系。这就是为什么在引用这些模型的输出时,术语“嵌入”(embedding)常与“向量”互换使用。
嵌入是由神经网络生成的,旨在捕捉数据中复杂的语义和关系。这些嵌入以高维空间中的向量形式表示,随后可以高效地存储在向量搜索引擎中并进行检索。
(2)稀疏向量
在数学上与稠密向量相同,但包含许多零。它们使用优化的存储表示,且形状与稠密向量不同。
表示法:稀疏向量表示为 (索引, 值) 对的列表
- index(索引):非零值的位置(整数)
- value(值):浮点数
1 | # Dense vector: [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 1.0, 2.0, 0.0, 0.0] |
indices(索引)数组和 values(值)数组必须长度相同,且所有 indices 必须是唯一的。
(3)多向量
虽然大多数模型对每个输入生成一个向量,但“后期交互”(late-interaction)模型(如 ColBERT)等高级技术会生成一组向量,通常每个 Token 一个。Qdrant 的多向量(multivector)功能允许你在单个点上存储整个矩阵。
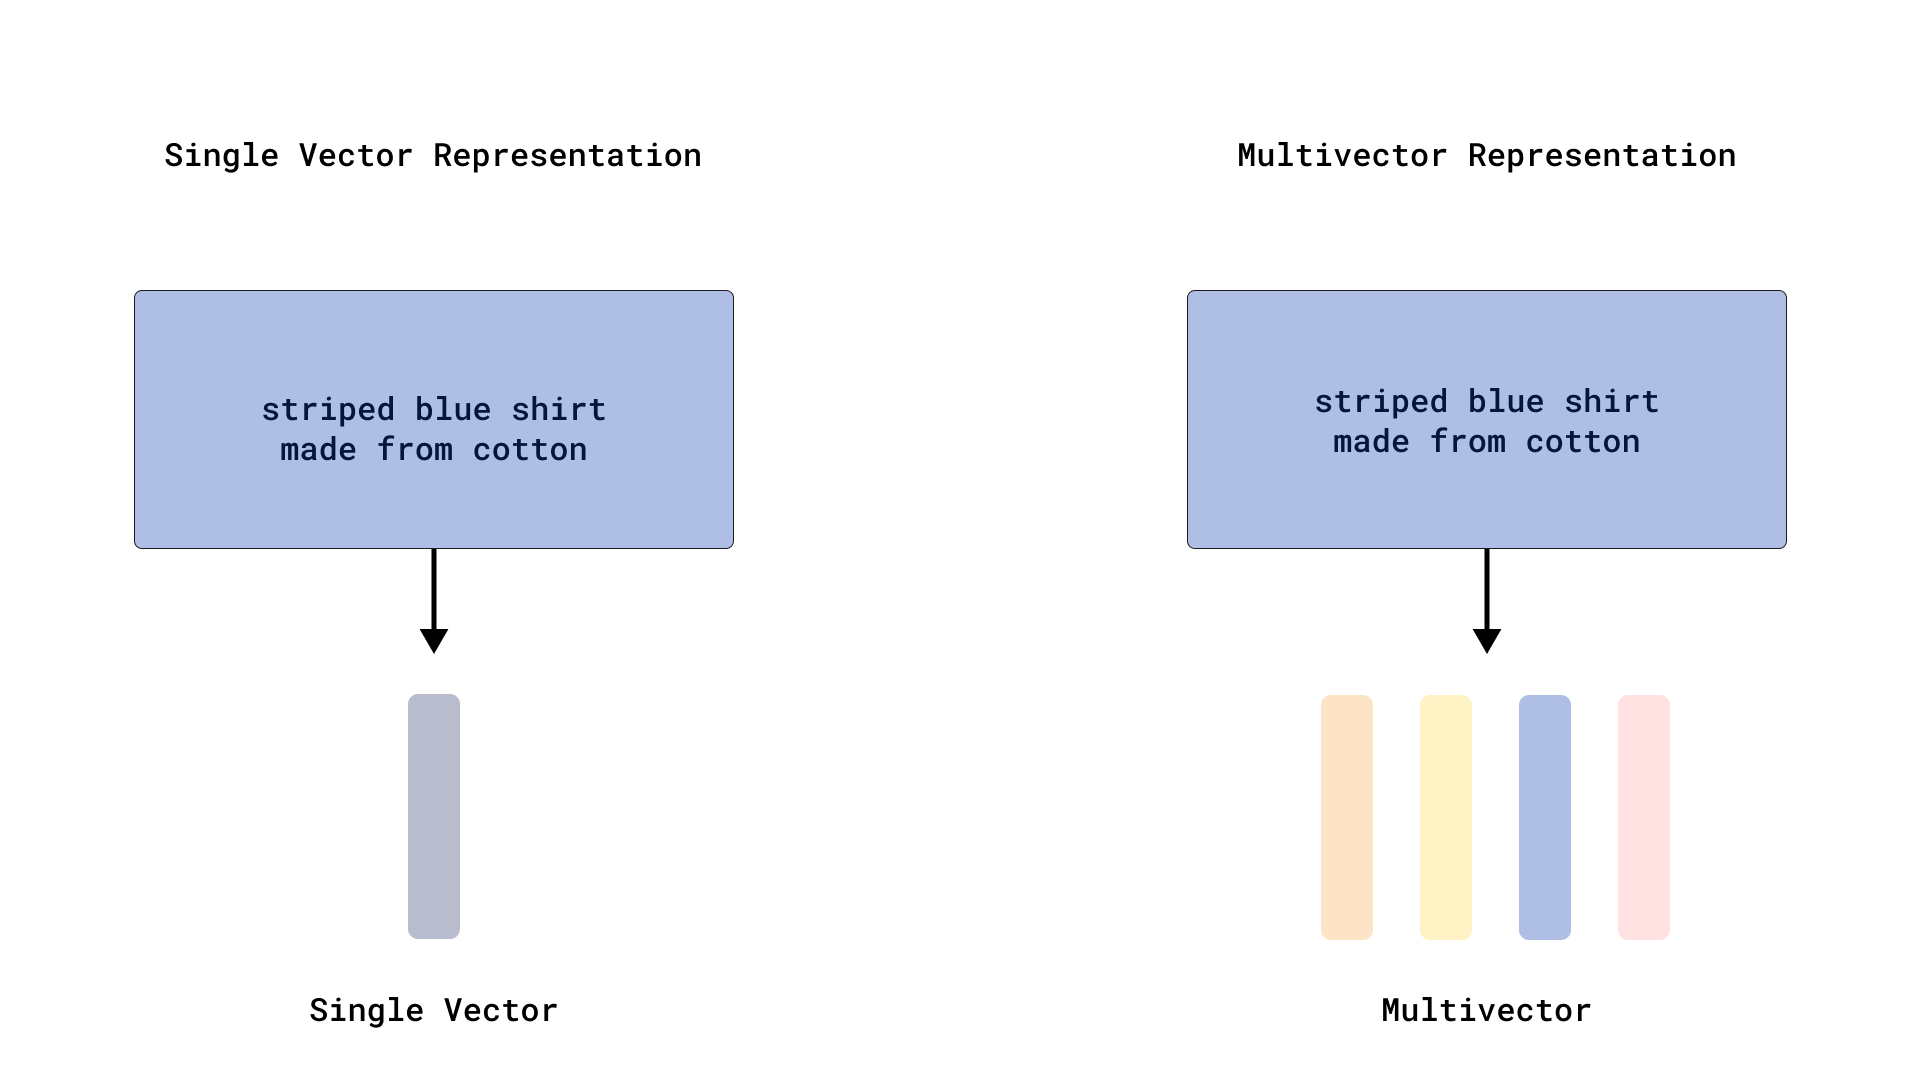
结构
- 每个集合的可变数量向量(多向量行)
- 每个独立向量的固定大小(多向量列)
1 | "vector": [ |
(4)命名向量
Qdrant 中一个 Point 可以保存多个向量,这些向量通过名称区分,所以叫“命名向量”。即将任何类型和结构的多个嵌入附加到同一个点上。
例如,一件商品同时有文字描述和商品图片:
1 | { |
另一个例子的python代码:
1 | client.upsert( |
常见用途包括:
- 同一对象的文字向量和图片向量
- 分别保存标题向量和正文向量
- 同一内容使用不同 Embedding 模型生成的向量
2.1.2.2 向量维度
向量维度直接影响搜索效率、内存消耗和检索准确性。
高维度能捕捉更多细节,但代价是更高的存储和计算成本。选择时需要在准确性和性能之间取得平衡:
- 较小的维度(384-512)速度最快但细节较少;
- 中等范围(768-1536)在准确性和速度上表现均衡;
- 更高维度(3072+)提供最大细节,但需要更多存储空间。
内存影响:一个 1536 维的 Float32 向量需要 6KB。如果扩展到 100 万个向量,你需要 6GB 内存。3072 维向量则使需求翻倍。
2.1.2.3 常见嵌入来源
合适的嵌入来源是平衡成本、性能和准确性的关键决策。以下是三种主要途径:
本地化、已优化:Qdrant 的 FastEmbed:独立使用的默认模型
BAAI/bge-small-en-v1.5非常轻量(约 67MB),。虽然qdrant-client集成允许指定任何兼容模型。1
2
3
4
5
6from qdrant_client import QdrantClient
from fastembed import TextEmbedding
# This example uses FastEmbed's default model for embedding generation
embedding_model = TextEmbedding()
vector = embedding_model.embed("Qdrant is a vector search engine")适用:1.需本地化;2.需CPU推理,但不想重依赖;3.Qdrant集成密切,成本低
托管与集成:云服务提供商:灵活。
本地化、可定制:开源模型:在你自己的硬件(CPU 或 GPU)上本地运行,但需要管理 PyTorch 或 TensorFlow 等依赖项。可微调
2.1.3 载荷(元数据)
虽然向量捕捉了数据的本质,但载荷存储了用于过滤和细化的结构化元数据。这种结合使得将向量的语义相关性与载荷的业务逻辑相结合成为可能。
载荷可以存储文本数据(描述、标签、类别)、数值(日期、价格、评分)以及复杂结构(嵌套对象、数组)。例如,在搜索狗的图片时,向量可以找到视觉上相似的图片,而载荷过滤器则将结果缩小到一年内拍摄、标记为“度假”或满足特定评分标准的图片。
载荷类型
| 类型 | 描述 | 示例 |
|---|---|---|
关键字 (Keyword) |
用于精确字符串匹配(例如:标签、类别、ID)。 | category: "electronics" |
Integer(整数) |
用于数值过滤的 64 位有符号整数。 | stock_count: 120 |
Float(浮点数) |
用于价格、评分等的 64 位浮点数。 | price: 19.99 |
Bool(布尔值) |
真/假值。 | in_stock: true |
地理位置 |
用于地理位置查询的经纬度对。 | location: { "lon": 13.4050, "lat": 52.5200 } |
Datetime(日期时间) |
RFC 3339 格式的时间戳,用于基于时间的过滤。 | created_at: "2024-03-10T12:00:00Z" |
UUID |
一种用于存储和匹配 UUID 的内存高效类型。 | user_id: "550e8400-e29b-41d4-a716-446655440000" |
数据结构
上述任何类型都可以存储在更复杂的结构中
- 数组:字段可以包含多个相同类型的值。如果数组中至少有一个值满足条件,则过滤器判定为成功。
- 示例:
tags: ["vegan", "organic", "gluten-free"]
- 示例:
- 嵌套对象:载荷可以是任意 JSON 对象,允许你存储结构化数据。可以使用点符号对嵌套字段进行过滤(例如:
user.address.city)。- 示例:
user: {"id": 123, "name": "Alice"}
- 示例:
过滤逻辑:构建复杂查询
Qdrant 的过滤系统使用逻辑子句,这些子句可以递归嵌套以创建复杂的查询逻辑。
逻辑子句
- must:所有条件都必须满足(AND 逻辑)
- should:至少有一个条件必须满足(OR 逻辑)
- must_not:所有条件都不应满足(NOT 逻辑)
例如,查找“200 美元以下的电子产品 OR 4 星以上好评的书籍”,其逻辑如下:
1 | models.Filter( |
条件类型:精确控制
除了基本的逻辑子句外,Qdrant 还提供了一套丰富的条件类型,用于针对不同种类的数据进行过滤。这些条件允许你构建符合应用需求的精确查询。
| 条件类型 | 用例 | 示例 |
|---|---|---|
匹配 (Match) |
用于关键词、数字或布尔值的精确值匹配。 | category: "electronics" |
范围 |
用于数值或日期时间的范围过滤。 | price > 100.0 |
地理位置 |
用于基于半径或边界框的地理位置过滤。 | location 位于柏林 5km 半径内 |
全文检索(Full Text) |
用于在文本字段中搜索特定的单词或短语。 | description 包含 "machine learning" |
嵌套(Nested) |
用于查询对象数组内部。 | reviews 中 rating > 4 且 verified = true |
高级过滤:嵌套对象
对于像对象数组这样的复杂数据结构,Qdrant 提供了嵌套过滤,确保条件是在单个数组元素内部评估,而不是跨所有元素进行评估。
考虑一个带有多个评论的产品
1 | { |
查找带有已验证的 5 星好评的产品(两个条件必须同时适用于同一条评论)
1 | models.Filter( |
性能优化
为了最大化过滤性能,须为频繁过滤的字段创建载荷索引。Qdrant 会根据过滤器的基数(cardinality)和可用索引自动优化查询执行过程。
1 | # Index frequently filtered fields |
2.2 距离度量
向量存储后,我们可以利用它们的空间属性执行最近邻搜索,根据向量在空间中的接近程度检索语义相似的项目。
(1)经验法则(最重要)
大多数用户不需要从零开始设计距离度量
- 使用第三方嵌入模型(OpenAI、Cohere、Hugging Face 等)
- 使用模型文档中推荐的距离度量(通常是余弦相似度或点积)。
- 使用该度量创建的 Qdrant 集合。
- 如果模型文档没有说明该使用哪种度量
- 在 Qdrant 中选择
Cosine(余弦)。 - Qdrant 会自动对 Cosine 集合中的向量进行归一化。一旦向量经过 L2 归一化,对于固定的查询,余弦相似度、点积和欧几里得距离将产生相同的排序结果,这使得余弦相似度成为不确定时的安全选择。
- 在 Qdrant 中选择
下面都为介绍
(2)余弦相似度 (Cosine Similarity)
- 常见用途:NLP 嵌入、语义搜索、文档检索。
- 重点:方向(朝向)。忽略幅度(模长)。
为了提高搜索效率,Qdrant 将余弦相似度实现为归一化向量上的点积。当集合的距离度量设置为
Cosine时,向量在上传过程中会自动进行归一化处理。
(3)点积相似度 (Dot Product Similarity)
- 常见用途:推荐系统、矩阵分解、排序。
- 重点:同时包含幅度和方向。
点积相似度是通过将两个向量中的对应值相乘,然后将这些乘积相加来计算的。与余弦相似度不同,该度量考虑了向量的长度。
使用场景:
- 推荐系统:如果用户向量代表偏好,那么与物品向量的点积越大,通常意味着相关性越高。
- 非对称搜索:当一个向量(例如查询)较短,而文档向量较长,且该长度意味着“更多信息”或“更高置信度”时。
(4)欧几里得距离 (L2 Distance)
- 常见用途:空间数据、异常检测、聚类。
- 重点:点之间的绝对距离。
欧几里得距离计算多维空间中两点之间的直线距离。当向量之间的精确数值差异很重要时,通常会使用它,例如在聚类算法(如 K-Means)中。(各维度之差的平方和 的平方根)
关键细节:欧几里得距离对尺度敏感。如果一个特征的范围是 1–100,而另一个特征的范围是 10,000–500,000,那么大范围的特征将主导距离计算。在使用欧几里得距离之前,通常需要对特征进行标准化或归一化处理。
(5) 曼哈顿距离 (Manhattan Distance)
- 常见用途:稀疏数据、鲁棒性异常值处理。
- 重点:基于网格的距离(绝对差之和)。
曼哈顿距离与欧几里得距离类似,但计算方式就像沿着网格线(水平和垂直)移动一样。(各维度之差 绝对值的和)
关键细节:每个维度对距离的贡献是线性的。单维度中的大偏差会线性增加距离,而不是像欧几里得距离那样呈二次方增加。这使得曼哈顿距离对单维度中的极端异常值不那么敏感。
| 指标 | 常见应用 | 原因? |
|---|---|---|
| 余弦相似度 (Cosine Similarity) | NLP, 语义搜索 | 忽略幅度;专注于语义含义(方向)。 |
| 点积 | 推荐、排序 | 同时捕获方向和幅度(重要性/流行度)。 |
| 欧几里得距离 | 空间数据、异常检测 | 测量绝对的物理或数值距离。 |
| 曼哈顿距离 (Manhattan Distance) | 稀疏/表格数据 | 相比欧几里得距离对异常值更具鲁棒性。 |
2.3 文本分块策略
现实世界中的大多数数据都是杂乱的:
- 文本文档很长
- 产品描述长度不一
- 用户画像具有嵌套属性
我们需要一种将这些数据分解为可管理块的方法。
数据预处理,特别是分块和嵌入(embedding),决定了 Qdrant 所处理的数据质量。
分块的目标是使数据块:
- 足够小,能够被嵌入模型有效处理,而不会被截断。
- 足够大,能够包含有意义且连贯的上下文。
通过将文档拆分为聚焦的块,每个块都会获得一个准确代表特定概念的向量。这使得搜索更加精确。
(1)固定大小分块(Fixed-Size Chunking)
方法: 定义每个块的 Token 数量(例如 200),并设置一个小的重叠缓冲区以保持上下文。
优点:易于实现;块大小一致;处理过程可预测
缺点:忽略自然语言边界;可能在句子中间或思想中间拆分;缺乏语义感知
最适合: 缺乏一致格式的文档、初步原型开发
(2) 基于句子的分块(Sentence-Based Chunking)
方法: 使用分词器将文档分解为句子,然后将句子组合成指定字数以下的块。
优点:保留完整的思想;遵循自然语言边界;良好的语义连贯性
缺点:块长度不规则;句子长度差异很大;可能无法遵循主题边界
最适合: RAG 系统、问答应用、通用文本处理
(3)基于段落的分块(Paragraph-Based Chunking)
方法: 利用现有的文档结构在段落处进行拆分。
优点:与自然主题边界对齐;默认具有丰富的语义;尊重作者的组织结构
缺点:不可预测的大小(从单行到整个页面);可能需要 Token 限制或后备拆分;取决于干净的文档结构
最适合: 文章、博客、文档、书籍、电子邮件
(4)滑动窗口分块(Sliding Window Chunking)
方法: 创建重叠块以保持上下文连续性。
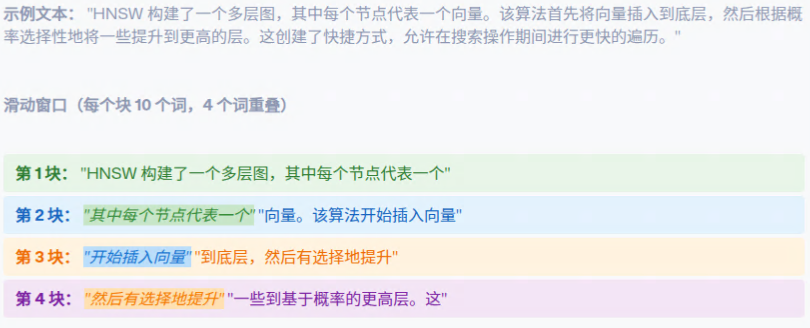
滑动窗口分块创建了一致大小的重叠段。每个块保持完全相同的字数(10 个词)和一致的重叠(4 个词),确保跨边界的信息连续性,同时保持统一的块大小。
优点:在边界处保持上下文;更高的召回潜力;减少信息丢失
缺点:存储冗余(通常有 20-50% 的开销);增加处理成本;可能会返回重复信息
最适合: 丢失信息代价高昂的关键应用、重排序系统
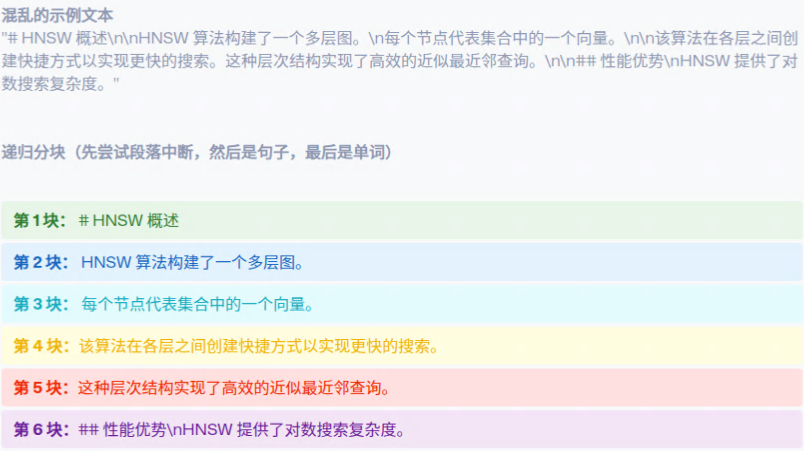
(5)递归分块(Recursive Chunking)
方法: 当数据不遵循可预测的结构时,使用备选的分隔符层次结构。
递归拆分使用后备层次的分隔符。递归分块试图保持结构。它从段落(由 \n\n 分隔)开始。如果它们太长,则降级为句子。如果它们仍然溢出,则在单词边界处切割。这种后备行为有助于即使在结构不一致时也能保持数据的可用性。
优点:适应杂乱或不一致的输入;尽可能保持语义连贯性;处理各种文档格式
缺点:基于启发式,结果可能不一致;逻辑复杂;可能无法完美适用于所有内容类型
最适合: 抓取的网页内容、混合格式、CMS 导出
(6)语义感知分块(Semantic-Aware Chunking)
方法: 使用嵌入来检测含义转换并在主题边界处进行拆分。
语义分块不关心句子数量或固定的 Token 限制。它寻找含义上的自然边界。如果一个定义需要多个句子,它会将它们保持在一起。这提供了更好的检索效果,因为块包含完整、连贯的概念。
过程
- 嵌入句子或小片段
- 计算连续段之间的相似度
- 识别相似度下降的主题转换点
- 在连贯性边界处进行拆分
优点:高语义精度;每个块都携带连贯的想法;复杂文档的最佳选择
缺点:计算成本高(需要嵌入整个文档);需要额外的模型推理;处理流水线较慢
最适合: 法律文件、研究论文、需要高精度的关键应用
| 方法 | 优势 | 权衡 | 最适合 |
|---|---|---|---|
| 固定大小 | 简单,块可预测 | 忽略结构,破坏含义 | 原始或非结构化文本 |
| 基于句子 | 保留完整的思想 | 块大小不一致 | RAG, 问答系统 |
| 基于段落 | 与语义单元对齐 | 长度差异大 | 文档、手册、教学内容 |
| 滑动窗口 | 保持完整上下文 | 冗余,计算量大 | 重排序,高召回检索 |
| 递归 | 灵活,处理混乱输入 | 启发式,有时易碎 | 抓取网页,混合来源 |
| 语义 | 高质量,语义感知 | 较慢,资源密集型 | 法律、研究、关键问答 |
用元数据增加含义:块本身只是文本片段。它们不会告诉您它们来自哪里,它们属于什么,或者如何控制检索的内容。
这就是元数据的用武之地。
在 Qdrant 中,这些元数据位于有效载荷(payload)中——这是一个附加到每个向量的 JSON 对象,承载了真实的结构。您可以用它存储任何需要识别或组织块的信息。
第三章 索引与性能
3.1 HNSW 索引基础
Qdrant 通过 HNSW — 分层可导航小世界(Hierarchical Navigable Small Worlds) 加速了暴力搜索(逐一计算每个point的距离)过程。
3.1.1 HNSW 的工作原理
HNSW 构建了一个多层图,其中每个向量都是一个节点。其思想是图具有分层结构:顶层包含少量联系广泛的节点,而每一层下层包含更多节点,连接也日益具体。
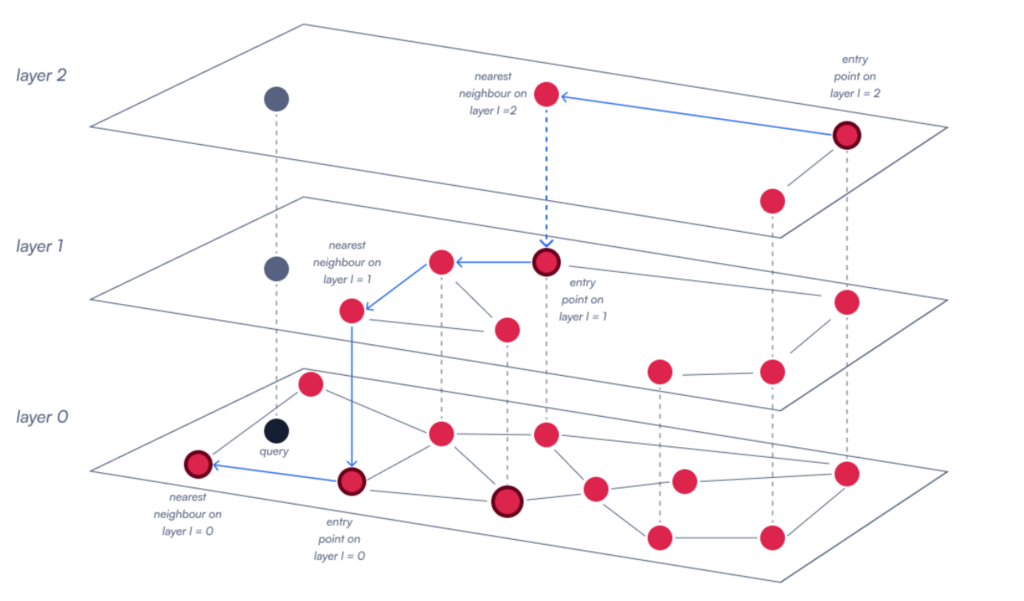
搜索过程:HNSW 从顶层的入口点开始,在图中向下导航,逐渐从广泛的连接转向更精确的连接。在每一层,算法都会探索当前节点的最近邻居,以确定最佳的前进路径。它持续这一过程,在下沉通过各层的同时不断优化搜索,直到到达最底层,选出最终的最近邻居。
3.1.2 HNSW 的配置方式
根据使用需求微调 HNSW 图的构建方式,以平衡搜索速度、准确性、内存使用量和索引时间。三个关键参数:m、hnsw_ef 和 ef_construct。
图连通性:
m— 控制图中每个节点的最大连接数。m值越大:邻居更多,这提高了搜索准确性,因为图有更多路径可供遍历,不太可能遗漏相关向量。然而,这也增加了内存占用和索引时间,因为需要维护更多的连接。m值越小:图越稀疏,减少了内存占用并加快了插入速度。但由于遍历路径减少,搜索准确性可能会下降。典型值:8 到 64 之间
构建彻底性:
ef_construct— 控制在插入新向量时检查多少个候选者。ef_construct值越高:意味着评估的邻居越多,生成的图更全面、准确。但这也使索引过程变慢,计算需求更高。ef_construct值越低:加快了插入过程,但图的连接可能不够优化,会影响搜索准确性。常用范围:100 到 500 之间。复杂数据可能需要更高的值以维持可靠的连接。
搜索彻底性:
hnsw_ef— 决定搜索查询期间评估的候选数量。hnsw_ef值越高:搜索结果越准确,因为算法探索了更大的邻域。但查询时间也会增加,因为处理的节点更多。hnsw_ef值越低:搜索速度更快,但准确性可能降低,因为考虑的候选向量较少。典型范围:50–200+,具体取决于延迟目标。
| 参数 | 目的 | 影响 |
|---|---|---|
| m | 每个节点的连接数 | 调高可改善召回率;使用更多内存和构建时间 |
| ef_construct | 插入时检查的候选数 | 调高可改善图质量;减慢索引速度 |
| hnsw_ef | 搜索时检查的候选数 | 调高可改善召回率;减慢查询速度 |
针对不同工作负载进行优化
- 高速检索: 调低
m和hnsw_ef;将ef_construct设置得刚好能满足可接受的召回率即可。 - 最大召回率: 调高
m、hnsw_ef和ef_construct,并接受更慢的查询和构建时间。 - 内存受限: 减小
m;保持ef_construct足够高以避免不良连接。
代码实战:
1 | from qdrant_client import QdrantClient, models |
3.1.3 不使用 HNSW 的场景
(1)小型集合
对于少于 10,000 个向量的集合,暴力搜索通常比构建 HNSW 更快且占用更少的内存。
(2)精确搜索要求
HNSW 是近似搜索。如果你需要精确结果,请使用暴力搜索。
(3)极端内存限制
对于非常紧张的内存预算,请考虑以下解决方案:
- 减小
m:HNSW 使用的额外内存与m × vectors_count成正比。 - 向量量化 (VQ)
- 标量量化 (SQ) 通常可以将内存需求降低约 4 倍。
- 二进制量化 (BQ) 将每个维度压缩为 1 位,可以显著压缩内存。
- 磁盘存储:将向量和 HNSW 索引设置为
on_disk=true,以使用 mmap 文件,仅将最常访问的向量缓存到内存中。 - 针对重排序嵌入禁用 HNSW: 这很有用,因为重排序向量(如多向量)非常大。
3.2 可过滤的 HNSW
当应用类似 price < 1000 的过滤器时,本质上是在搜索过程中限制了哪些点是符合条件的。这给图遍历带来了挑战,因为 HNSW 要求图中的任何点都是可达的。但如果过滤操作移除了大部分点,搜索路径可能会中断。
朴素方法及其问题
- 后过滤 (Post-Filtering):最初忽略过滤器:在整个数据集上进行搜索,获取前 K 个最相似的向量,然后应用过滤器。
- 问题:可能会丢弃大部分前 K 个结果。如果满足过滤器的最佳匹配项不在前 K 个结果中,您将无法检索到它。
- 预过滤:另一种方法是先进行过滤,然后在过滤后的集合中搜索。
- 问题:当过滤条件过于严格时,它们会使 HNSW 图碎片化,破坏连通性,导致遍历效率低下或无法进行。
Qdrant 的解决方案:可过滤的 HNSW (Filterable HNSW)
创建额外的边来维持过滤条件下的连通性,从而保证 HNSW 图始终保持连接。Qdrant 为每个 payload 值构建子图,然后将其合并回完整图。
因此,如果您过滤 brand = Apple,Qdrant 已经构建了一个仅包含 Apple 点的连通子图,遍历在该子集内可以正常工作。
查询规划器:自适应策略
在查询时,Qdrant 使用查询规划器来确定合适的策略。此规划针对每个分段(segment)进行,并基于过滤基数、索引可用性以及诸如
full_scan_threshold之类的阈值。- 过滤器匹配点数较多:Qdrant 执行常规 HNSW 搜索,但在遍历过程中跳过不匹配的节点。这避免了对大型结果集进行预过滤的开销,同时保持了搜索的快速和近似性。
- 过滤器匹配点数较少:如果过滤器仅匹配集合中的一小部分,Qdrant 可能会完全跳过 HNSW,并在速度更快的情况下退回到简单的全量扫描(full scan)。
Payload 索引:基础层
Qdrant 默认不对 payload 字段进行索引。必须明确定义要索引的字段。最佳实践是在上传任何数据之前创建 payload 索引,以便 HNSW 可以构建感知过滤器的链接。
代码执行过滤:
1 | # Create filter combining multiple conditions |
第四章 混合搜索
4.1 稀疏向量
4.1.1 稀疏向量的表示
稀疏向量是高维向量,除少数维度外,其余维度均为零。稀疏向量的每个维度都指向特定的对象,其值则代表该对象在这一稀疏表示中的权重(角色)。
让我们考虑一个电影推荐系统
- 每个稀疏向量都可以描述特定用户的观点。
- 每个维度可以代表某部电影 M_X,而其值则代表用户对该电影的评分。
1 | M1 M2 M3 M4 M5 M6 M7 M8 M9 M10 |
存储形式
存储成千上万个不提供任何信息的零值是极其浪费的。
因此,稀疏向量可以紧凑地存储为其非零项的 (索引, 值) 对。
1 | [0, 0, 0, 0, 0, 0, 1.0, 2.0, 0, 0] |
4.1.2 稀疏向量搜索方式
搜索相似的稀疏向量,归根结底就是找出那些与查询向量共享非零维度的向量,并将对应的数值相乘(即点积)。
在大规模场景下,扫描每个向量以检查匹配的非零维度效率太低。
简单想法是:维护一个从维度索引到(具有非零维度权重的)向量的映射。在查询时:
- 对于查询向量的每个非零维度,检查映射项以收集匹配的向量。
- 仅针对这些候选对象,通过重叠的非零索引计算点积来评分。
4.1.3 Qdrant 中稀疏向量的创建、搜索
(1)创建稀疏向量集合
Qdrant 集合中的稀疏向量通过 sparse_vectors_config 进行配置。
与稠密向量配置不同,我们无需为稀疏向量定义大小 (size) 或距离度量 (distance metric)。
- 大小取决于稀疏向量中非零元素的数量。
- 非零元素的最大数量(即稀疏向量的大小)受
uint32类型限制,意味着最多可有 4,294,967,296 个非零元素。
- 非零元素的最大数量(即稀疏向量的大小)受
- 用于比较稀疏向量的距离度量始终是
点积 (Dot product)。
稀疏向量在 Qdrant 中不是默认配置(与稠密向量不同)。因此,若要配置包含稀疏向量的集合,必须始终为它们指定一个名称。
1 | # 创建一个指定名称稀疏向量的集合 |
(2)调整倒排索引(可选)
默认设置已经过优化。
参数
full_scan_threshold(int) – 当向量数量小于此阈值时,在比较过程中不会使用倒排索引(但索引仍会被构建)。on_disk(bool) – 将倒排索引存储在磁盘上 (True) 或内存中 (False,默认)。datatype– 存储在索引内部的值的精度:uint8|float16|float32(默认)。- 无论
datatype的值如何,原始值仍会存储在磁盘上。
- 无论
1 | client.create_collection( |
(3)存储向量的方式
稀疏向量由以下部分表示:
indices– 非零维度的索引(存储为uint32,范围可从 0 到 4,294,967,295)。indices在单个向量内必须是唯一的。
values– 这些非零维度的值(存储为浮点数)。len(indices) == len(values).
1 | client.upsert( |
(4)搜索稀疏向量
通过 using="sparse_vector" 指定要搜索的命名向量。
1 | client.query_points( |
4.2 稀疏向量关键词搜索
举例词袋模型:
考虑一个杂货店商品描述的数据集(英文)。农产品的词表可以是英语的一个相对较小的子集,从“apple”到“zesty”进行排序并相应枚举。
1 | Vocabulary indices (illustrative): |
使用词表索引,我们可以将每个描述表示为由 (索引, 值) 对组成的稀疏向量。
其值可以是词频 (TF)。
词频 (Term Frequency, TF):一个词在文本中出现的次数。
描述:
Grated hard cheese(磨碎的硬奶酪)
稀疏向量1
[(101, 1.0), (151, 1.0), (190, 1.0)]
描述:
Mac and cheese(通心粉奶酪)
稀疏向量1
[(20, 1.0), (101, 1.0), (501, 1.0)]
(注意单词
cheese共享的索引101)
4.2.1 TF-IDF
IDF—逆文档频率 (Inverse Document Frequency) :一种语料库级别的统计量,表示有多少文档包含某个词。词越稀有,其 IDF 值就越高。比如在一个杂货店的语料库中,关键词 mozarella 比 tasty (很可能经常出现)更重要,因为它更稀有。
因此,越稀有IDF越大,即 IDF = ln(频率)
因此,存储的向量除了上述TF,还要标量乘上IDF
1 | "Grated hard cheese" = |
Qdrant中的IDF
Qdrant 为稀疏向量维护集合级别 (collection-level) 的 IDF,并在评分过程中自动为您应用它。
在集合配置中启用 IDF 修饰符
1 | client.create_collection( |
TF-IDF 没有考虑到文档长度会影响文档中使用词语的重要性
4.2.2 BM25
信息检索中非常著名的公式——最佳匹配 25 (BM25),对 TF-IDF 模型进行了几项调整,将文档长度纳入了评分。
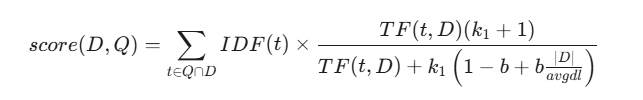
控制文档长度归一化和 TF 饱和度的额外参数
k_1:控制 TF 饱和度(查询词在文档中额外出现的次数对得分的影响程度)。b:控制文档长度归一化,平衡|D|(文档长度)与文档平均长度avg_corpus(|D|)。
公式作用:
- 防止 TF 无限增加得分;
- 修正文档长度的影响:
- 同一个词出现 3 次:
- 在一篇 20 字的短文中:可能是核心词
- 在一篇 10000 字的长文中:可能只是偶然出现
- 因此:
- 文档比平均长度长 → 分母增大 → 得分降低
- 文档比平均长度短 → 分母减小 → 得分提高
Qdrant 中的BM25
在 Qdrant 中使用任何包含 IDF 的检索公式(如 BM25)时,不再需要在稀疏文档表示中包含 IDF 组件。IDF 组件将由 Qdrant 在计算相似度得分时自动应用。
1 | client.create_collection( |
Qdrant 与 FastEmbed 的集成允许在将文档索引到 Qdrant 时简单地传递文本和 BM25 公式参数。转换为稀疏向量的过程在后台自动完成。
1 | grocery_items_descriptions = [ |
FastEmbed 中的 BM25:实现细节
(1)语料库平均长度
Qdrant 和 FastEmbed 不会计算 avgcorpus|D|(语料库中的平均文档长度)。必须估计并提供此值作为 BM25 参数。
(2)FastEmbed (Qdrant) 中的默认 BM25 参数
k = 1.2b = 0.75
(3)文本处理流水线
FastEmbed 使用 Snowball 词干提取器将词语还原为词根或基本形式,并应用特定语言的停用词列表(例如英语中的 and, or)来减少词表大小并提高检索质量。
基于 BM25 和 Qdrant 的词汇检索
测试我们在 Qdrant 中基于 BM25 的词汇搜索。
1 | client.query_points( |
检索流程剖析
第 1 步:处理查询关键词
对于查询中不是目标语言停用词的关键词,FastEmbed 会依次进行以下处理:
提取词干或基本形式。
1
cheese → chees
将词干映射到词表中的稀疏向量索引。
1
chees → 1496964506
该索引代表词语所在的稀疏向量维度,主要用于匹配查询和文档中的相同词语。
第 2 步:通过倒排索引查找文档
Qdrant 使用关键词索引 1496964506 查询倒排索引,快速找到所有包含 cheese 的文档。
对于每个候选文档 (D),FastEmbed 会预先计算并存储该词的文档侧 BM25 权重:
其中:
- (t):当前关键词,例如
cheese - (TF(t,D)):关键词在文档 (D) 中的出现次数
- (|D|):文档长度
- (avgdl):语料库中的平均文档长度
- (k_1):控制 TF 饱和程度
- (b):控制文档长度归一化程度
这部分同时考虑了关键词出现次数和文档长度。
第 3 步:应用集合级 IDF
Qdrant 根据整个 Collection 的统计信息计算关键词的 IDF,并用它调整文档侧权重:
对于关键词 cheese:
某个词出现在越少的文档中,其 IDF 越高,对最终得分的贡献通常也越大。
第 4 步:汇总所有匹配关键词的得分
如果查询包含多个关键词,Qdrant 会计算每个匹配关键词的得分并求和:
其中:
- (Q):查询
- (D):候选文档
- (Q\cap D):查询和文档共同包含的关键词
最终,Qdrant 按 BM25 得分从高到低排列文档。
4.2.3 稀疏神经检索
以上这种词袋模型方法均没有考虑词序。它统计词语,但不建模哪些词出现在哪些词旁边,即上下文。然而,一个词的含义很大程度上是由其上下文决定的。
- 示例:考虑
"I want some hard-to-get cheese"(我想要一些难买的奶酪)和"I want to get some hard cheese"(我想要买一些硬奶酪)。这两个句子使用相同的词,但由于词序不同,赋予了单词cheese不同的含义。
稠密检索(Dense retrieval)似乎是完美的解决方案,但在许多领域,基于关键词的搜索之所以具有吸引力,是因为它可解释、精确且不需要过高的召回率。问题在于:我们如何在保持精确匹配的同时,使其具备语义感知能力?
一种常见的模式是使用 BM25 进行检索,然后使用理解上下文的模型对匹配的文档进行重排序 (rerank)。然而,重排序所有候选文档可能非常昂贵。让检索器本身从一开始就具备语义感知能力效率更高。
(1)稀疏神经搜索背后理念
我们不应仅仅根据语料库统计数据来分配词权重,而可以使用已被证明能够捕捉词语上下文含义的机器学习模型。
在实践中,稀疏神经检索器的作者通常从稠密编码器开始,并对其进行适配,以生成稀疏文本表示:形状类似于词袋模型,但权重由机器学习模型生成。
处理过程:
1 | 文本 |
(2)SPLADE:稀疏词汇与拓展模型
SPLADE 是一种基于 Transformer/BERT 的稀疏检索模型。它利用上下文生成原词和相关扩展词的权重。
它不仅给原文中的词赋权,还可能激活原文没有出现、但语义相关的词。例如,查询 cheese 后,模型可能同时激活 dairy、food 等维度。
这里的“扩展”不是修改原文,而是在稀疏向量中增加相关词的非零维度。
查询扩展示例:
1 | cheese |
文档扩展示例:
1 | Mac and cheese |
搜索时,查询向量和文档向量通过相同的原词或扩展词产生匹配。
例如:
1 | 查询:hard grated cheese |
这解决了当语义相关的文本使用不同词语(例如 hard grated cheese 与 parmesan)时的词汇不匹配问题 (Vocabulary Mismatch problem)。
Qdrant 中的 SPLADE
创建集合
1
2
3
4
5
6
7# 与基于 BM25 的检索不同,这里没有配置逆文档频率 (IDF) 修饰符。
client.create_collection(
collection_name=<COLLECTION_NAME>,
sparse_vectors_config={
"splade_sparse_vector": models.SparseVectorParams(),
},
)使用 FastEmbed 创建并插入 SPLADE++ 稀疏向量
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22# 原始文本,后续每条均形成point
grocery_items_descriptions = [
"Grated hard cheese",
"White crusty bread roll",
"Mac and cheese"
]
client.upsert(
collection_name=<COLLECTION_NAME>,
points=[
models.PointStruct(
id=i,
payload={"text": description},
vector={
"splade_sparse_vector": models.Document( # splade_sparse_vector为命名向量的名称,需要与 Collection 创建时的配置一致。
text=description, # 需要向量化的文本
model="prithivida/Splade_PP_en_v1" # 指定使用的 SPLADE 模型
)
},
) for i, description in enumerate(grocery_items_descriptions)
],
)可以分为两步:
1
文本 → Tokenizer 生成标记索引 → SPLADE 生成标记权重
文本到标记:Tokenizer 会将文本拆成模型能够识别的标记,并在模型词表中查找每个标记的编号。
1
2
3
4"mac and cheese"
mac → 6097
cheese → 8808SPLADE 标记加权:标记索引会被送入 SPLADE 的 Transformer 编码器。模型根据整段文本的上下文,为整个词表中的标记计算权重。
1
2"mac and cheese" → cheese 更接近食品、菜肴
"cheese company" → cheese 可能更接近公司、品牌最终稀疏表示:SPLADE 的完整向量维度等于模型词表大小,例如数万个维度,但大多数维度都是零。
1
2indices = [6097, 8808, dairy索引, dish索引, ...]
values = [mac权重, cheese权重, dairy权重, dish权重, ...]
进行稀疏神经检索
1
2
3
4
5
6
7
8
9
10client.query_points(
collection_name=<COLLECTION_NAME>,
using="splade_sparse_vector",
limit=3,
query=models.Document(
text="parmesan",
model="prithivida/Splade_PP_en_v1"
),
with_vectors=True,
)整体流程:
1
2
3
4
5
6
7
8原始文本
→ 分词和子词切分
→ 映射为词表索引
→ Transformer 理解上下文
→ 为原词和扩展词分配权重
→ 保留少量非零维度
→ 得到 SPLADE 稀疏向量
→ 使用倒排索引进行检索
4.3 混合搜索和通用查询API
用户通常是模糊的自然语言描述者,强行使用单一的搜索方法意味着会让一部分用户感到失望。混合搜索允许您在用户所在的层面上满足他们,而不是在搜索质量上向特定用户类型妥协。
- 稠密向量(语义理解):由神经编码器生成,这些编码器以关联输入含义的方式进行训练。无论是要找 elevator(电梯)还是 lift(电梯),意图都是到达另一层楼,即使单词不同。
- 稀疏向量(精确匹配):更适合需要精确匹配的场景。它们通常被称为基于关键词或词汇的搜索。
4.3.1 混合搜索的定义
混合搜索没有单一的定义,但通常情况下,当一个特定的管道结合了至少两种不同的搜索方法时,我们可以称之为混合。
可以是稠密和稀疏向量的链式组合,在这种情况下:
- 预取(Prefetch):通过稠密向量搜索获取一些候选结果。
- 重排序(Rerank):使用稀疏向量对它们进行重新排序。
或者反之:使用稀疏进行检索,使用稠密进行重排序。因此,我们有了检索器(retrievers)和重排序器(rerankers)。
4.3.2 通用查询API
(1)稠密检索 -> 稀疏重排序
1 | from qdrant_client import QdrantClient, models |
(2)稀疏检索 -> 稠密重排序
1 | from qdrant_client import QdrantClient, models |
(3)顺序搜索的局限性
连续使用多种搜索方法并不总是最佳途径。考虑之前的示例:
- 使用稠密向量检索文档,然后用稀疏方法重排序,或者
- 使用稀疏方法检索,然后用稠密方法重排序。
这两种方法可能会产生完全不同的结果。 初始检索方法实际上比重排序步骤更关键,因为重排序只能处理检索器已经选出的结果。
4.3.3 融合搜索与 RRF
每种检索方法都会为它选择的每个文档生成一个数值评分。这些评分无法在不同方法之间直接进行比较,因此没有明确的方法来混合候选者。
融合算法旨在解决这个问题。倒数排名融合(RRF)是最常见的技术之一。
RRF (倒数排名融合)
每种方法返回的原始评分主要用于按相关性对文档进行排序,因此它们决定了每个结果的优劣顺序。RRF 不考虑原始评分,只考虑它们定义的排名,并根据每种单独方法返回的排名计算自己的评分。
示例解析
假设从两种方法中获得了以下结果:
稠密搜索结果:
- D1(得分:0.95)
- D2(得分:0.89)
- D3(得分:0.85)
- D4(得分:0.82)
稀疏搜索结果:
- D5(得分:15.2)
- D3(得分:12.8)
- D1(得分:10.1)
- D2(得分:8.5)
| 文档 | 稠密排名 | 稠密 RRF | 稀疏排名 | 稀疏 RRF | 总 RRF | 最终排名 |
|---|---|---|---|---|---|---|
| D1 | 1 | 1/(60+1) = 0.0164 | 3 | 1/(60+3) = 0.0159 | 0.0323 | 1 |
| D2 | 2 | 1/(60+2) = 0.0161 | 4 | 1/(60+4) = 0.0156 | 0.0317 | 3 |
| D3 | 3 | 1/(60+3) = 0.0159 | 2 | 1/(60+2) = 0.0161 | 0.0320 | 2 |
| D4 | 4 | 1/(60+4) = 0.0156 | - | 0 | 0.0156 | 5 |
| D5 | - | 0 | 1 | 1/(60+1) = 0.0164 | 0.0164 | 4 |
注意: D1 成为了赢家,尽管它并不是每种方法单独匹配的最佳结果!然而,两者都将其排名得相当高,因此它很可能同时捕获了词汇和语义含义。
Qdrant 中实现RRF
1 | from qdrant_client import QdrantClient, models |
超越融合:高级重排序
融合并不是构建混合搜索的唯一方法。有时,您拥有更大的一组弱检索器和一个强重排序器,这可能是:
- 不同的神经模型,例如交叉编码器(cross-encoder)。
- 更复杂的稠密检索器,在初始检索中实际上可能无法应用。
- 多向量表示,例如 ColBERT。
- 特定于您项目的自定义业务规则。
混合搜索可能非常复杂。 重排序是我们在某些中间搜索操作的结果上应用的所有方法的通用术语,而融合是解决该问题的一种方式。
第五章 优化与拓展
5.1 向量量化方法
生产环境中的向量搜索引擎面临着一个不可避免的扩展挑战:内存需求随数据集大小而增长,而搜索延迟则要求向量必须驻留在快速存储中。量化提供了一种解决方案,通过压缩向量表示来降低内存占用,同时保持检索质量——但你所选择的方法从根本上决定了系统的性能特征。
例如:OpenAI 的 text-embedding-3-small 模型生成的 1536 维向量,每个向量需要 6 KB 内存(1536 × 每个 float32 占 4 字节)。其扩展规模是可以预见的:100 万个向量占用 6 GB,1000 万个需要 60 GB,而 1 亿个则需要 600 GB 的内存。按云服务定价计算,这会转化为巨大的基础设施成本。
5.1.1 标量量化
标量量化将每个 float32 维度(4 字节)映射为 int8 表示(1 字节),通过学习范围映射实现 4 倍的内存压缩。
- 该算法在量化前,系统会分析全部向量值的分布,确定一个映射区间:下边界 lower、上边界 upper(使用的是分位数,排除异常的值,避免影响范围)。
- 然后将该区间划分成 256 个等级,映射到
int8的-128~127。
标量量化之所以成为生产环境的默认选择,是因为它在各种嵌入模型中都能保持 99% 以上的准确率,同时提供可预测的压缩比。
1 | # Scalar quantization setup |
5.1.2 二值量化
二值量化代表了极端的压缩方法,通过基于符号的阈值处理将每个维度简化为单个位:大于零的值变为 1,小于或等于零的值变为 0。这使得一个 1536 维的向量从 6 KB(1536 × 4 字节)压缩到 192 字节(1536 位 ÷ 8),实现了 32 倍的内存压缩。
然而,二值量化对模型特性有特定要求以达到最佳性能。该技术最适用于表现出围绕零点中心分布的高维向量(≥1024 维)。OpenAI 的 text-embedding-ada-002 和 Cohere 的 embed-english-v2.0 等模型已验证其二值兼容性,但其他模型可能会经历显著的精度下降。
1 | # Binary quantization setup |
5.1.3 乘积量化
乘积量化采用分治法,将向量分割成子向量,并使用学习到的码本(codebooks)对每个片段进行编码。该算法将高维向量拆分为等长的子向量,然后独立地对每个片段应用 k-means 聚类,为每个片段创建包含 256 个质心的独立码本。
这种压缩机制存储的是质心索引,而不是原始值。一个被分为 128 个子向量(每个 8 维)的 1024 维向量仅需 128 字节即可存储(128 个索引 × 1 字节),实现了约 32 倍的压缩。在极端配置下,乘积量化可以达到 64 倍的压缩比。
其代价是计算复杂度和精度下降。距离计算变得不再兼容 SIMD,通常导致查询性能比未量化的向量更慢。分段编码引入了在子向量间累积的近似误差,与标量或二值方法相比,会导致更显著的精度损失。乘积量化适用于极端压缩需求超过精度和速度考虑的专用场景。
1 | # Product quantization setup |
| 量化方法 | 精度 | 速度 | 压缩率 |
|---|---|---|---|
| 标量 | 0.99 | 最高 2 倍 | 4x |
| 二值 (Binary) | 0.95* | 最高 40 倍 | 32 倍 |
| 乘积 | 0.7 | 0.5 倍 | 最高 64 倍 |
5.2 恢复量化损失精度
使用标量、二进制或乘积量化等量化方法时,是在对向量进行压缩以节省内存并提高性能。然而,这种压缩可能会略微降低相似度搜索的准确性,因为量化后的向量只是原始数据的近似值。为了缓解这种准确性损失,可以使用过采样(oversampling)和重评分(rescoring),这有助于提高最终搜索结果的准确度。
Qdrant 可以通过“过采样 → 原向量重评分 → 重排序”的两阶段流程尽量恢复检索精度。
5.2.1 过采样
过采样是指:初次使用量化向量搜索时,获取比最终所需数量更多的候选 Point。
1 | 候选数量 ≈ limit × oversampling |
过采样本身不会修正量化分数,只是扩大候选范围,减少真正相关的 Point 因量化误差而被提前淘汰的概率。
过采样因子越大:
- 召回质量通常越高。
- 需要重新读取和计算的原始向量越多。
- 查询延迟和资源消耗也会增加。
5.2.2 原向量重评分
获得候选 Point 后,Qdrant 会读取这些 Point 对应的原始 float32 向量,重新计算查询相似度。
需要注意:重评分并不是将 int8 向量还原成 float32(标量量化举例),而是直接使用保留下来的原始向量。
1 | 量化向量:负责快速找候选 |
内置的量化重评分只重新计算向量相似度,不会自动加入上下文、Payload 或其他业务规则。若需要使用交叉编码器或元数据进行排序,需要另外实现。
重新计算原始向量分数后,Qdrant 会按照新分数重新排列候选 Point,并返回最终的 Top-K。
1 | response = client.query_points( |
5.3 大规模数据上传
在向量搜索应用中,插入几千个数据点非常简单,但当处理数百万或数十亿条记录时,动态特性会发生彻底改变。上传过程中细微的效率低下会累积成巨大的时间损耗、增加内存压力,并导致搜索性能下降。
每一次 upsert(插入/更新)调用都会发起一个事务,消耗内存和磁盘 I/O 来构建索引的部分内容。在大规模场景下,这种简单粗暴的方法可能会压垮您的系统,导致上传时间飙升,搜索质量下降。
5.3.1 上传策略
需要注意的是,Qdrant 只有 Python 客户端支持 upload_points 和 upload_collection 方法。如果使用的是其他语言的客户端,建议在大规模摄入时使用带批量上传功能的 upsert。
- upsert(单个或批量):这是添加或更新点的基础操作。单个 upsert 最适合实时更新,而批量操作最适合更大规模的工作负载。适用:少于 10 万个点:单线程的批量 upsert 操作通常表现良好。
- upload_points:此方法经过优化,用于上传可以轻松放入客户端内存的整批数据点。它利用了延迟批量处理、重试和并行处理等功能,是中等规模数据集的强力选择。适用:10 万到 100 万个点,批次大小设置在 1,000 到 10,000 之间,以平衡网络开销和内存使用。
- upload_collection:对于真正的大规模数据集,upload_collection 是最强大的工具。它直接从迭代器流式传输数据,这意味着不需要一次性将整个数据集加载到内存中。这种内存高效的方法非常适合摄入数百万或数十亿个点。适用:超过 100 万个点为了最大化吞吐量,应该设置
parallel参数,将其值设为可用 CPU 核心数(例如 4 或 8),以启用并行处理。
5.3.2 案例:400M
数据规模:LAION-400M 约包含:
- 4 亿个图像—文本对
- 每条数据一个 512 维 CLIP 向量
- 约 200 GB Payload
如果 Qdrant 使用 float32 存储向量,理论大小为:
1 | 4 亿 × 512 × 4 字节 ≈ 819 GB |
存储与搜索设计的整体思路:
1 | 磁盘:保存原始 float32 向量和 Payload |
collection配置:
1 | client.create_collection( |
LAION-400M 被拆成约 409 个部分,每部分约 100 万条记录。上传时逐部分下载和处理,不需要一次加载全部数据。
更稳妥的方式是继续把每个部分拆成小批次:
1 | def upload_batch( |
上传流程:
1 | next_id = 0 |
该配置并非所有 4 亿级数据集的固定最优方案。实际生产环境还需要根据机器内存、磁盘吞吐、召回率要求以及集群分片数量进行压测和调整。
第六章 高级API
6.1 后期交互模型的多向量
普通稠密检索通常将 Transformer 输出的所有 Token 向量池化为一个向量:
1 | 多个 Token 向量 |
假设一个 Point 表示文档:
1 | D:"Apple released a new phone" |
Transformer 首先为文档中的每个 Token 生成上下文化向量:
1 | Apple → d₁ |
普通稠密模型将这些 Token 向量池化:
1 | [d₁, d₂, d₃, d₄] |
被压缩的是一个文档内部的多个 Token 向量。
这种表示存储小、检索快,但会把文档中的多个主题压缩在一起,可能丢失局部细节。
分块可以缓解这一问题,但会增加 Point 数量,并可能破坏跨块上下文。
像 ColBERT 这样的后期交互模型保留了每个 token 的文档向量。比如:上述D → [d₁, d₂, d₃, d₄]。在搜索时,它们通过比较所有查询 token 与所有文档 token 来识别最佳匹配。这种 token 级别的精度保留了局部语义匹配,并提供了卓越的相关性,特别是在处理复杂的查询和文档时。
6.1.1 后期交互:Token 级别的精度
Qdrant 通过多向量表示 (multivector representations)实现了这一强大的技术。多向量字段包含一个有序的子向量列表,每个子向量捕获文档的一个不同 token。
在查询时,Qdrant 执行后期交互评分。它将每个查询 token 嵌入 qi 与每个文档 token 嵌入 dj 进行比较。每个查询 token 只保留最高的分数,然后将这些最高分求和。
1 | 查询:refund policy |
多向量通常按照 Token 顺序生成,但 MAX_SIM 不直接要求位置一一对应,而是为每个查询 Token 寻找最佳文档 Token。
6.1.2 Qdrant 中的多向量
Qdrant 的多向量结构
Qdrant 的一个 Point 可以包含一个名为 colbert 的向量字段,该字段内部存储多个子向量:
1 | Point |
生成 Token 级别向量
1 | from fastembed import LateInteractionTextEmbedding |
创建多向量 Collection
1 | client.create_collection( |
关闭 HNSW 后,直接查询会对范围内的 Point 执行暴力 MaxSim 计算:
- 精细匹配能力强。
- 小型数据集可以直接使用。
- 大型 Collection 中速度和存储成本较高。
写入文档多向量
1 | client.upsert( |
一个 Point 仍然代表一个文档或文本块,只是该 Point 的 colbert 字段包含多个 Token 子向量。
使用 ColBERT 查询
1 | query_vector = next( |
Qdrant 会使用 MAX_SIM 比较查询 Token 和文档 Token,并根据总分返回结果。
6.2 通用查询API
设想一下:客户在商店的搜索栏中输入“皮夹克”。你希望展示在语义上匹配该样式的商品——这样即使商品描述中没有明确提到“皮夹克”,飞行员夹克(bomber jacket)也会显示出来——但同时你还需要执行业务规则。例如:仅限 200 美元以下的商品、仅限有货的商品、仅限过去一年内发布的产品。传统做法是:发起搜索、收集结果、然后应用过滤器和编写融合代码。使用 Qdrant 的 通用查询 API (Universal Query API),所有这一切都可以在一个声明式请求中完成。
6.2.1 方式一:RRF
首先,从多个来源并行检索候选结果并融合它们的排名。
1 | response = client.query_points( |
6.2.2 方式二:密集检索 + ColBERT 重排序
上一节展示了如何直接使用 ColBERT 进行检索,但在生产系统中,重排序(reranking)是更常见的模式。原因很实际:ColBERT 在整个大型集合上进行暴力 MaxSim 评分可能很慢。
1 | client.create_collection( |
通过带有 HNSW 索引的密集字段快速检索出 100 个候选结果,然后应用 ColBERT 的 MaxSim 评分对这 100 个结果进行重排序,并挑选出最顶尖的十个:
1 | from fastembed import LateInteractionTextEmbedding, TextEmbedding |
6.2.3 全局过滤器和预取专用过滤器
可以根据需要在任何合适的地方分层添加过滤器。
全局过滤器
定义在 query_points() 顶层,应用于所有预取分支。
本例要求所有候选商品都满足:
1 | 价格 < 200 美元 |
预取专用过滤器
定义在某个 Prefetch 内,只限制该检索分支。
本例中,稠密检索还要求:
1 | 有库存 |
1 | 全局过滤器 G |
1 | # 在 `QdrantClient.query_points()` 中,顶层过滤参数通常写作 `query_filter`;`Prefetch` 内部仍使用 `filter`。 |