栈
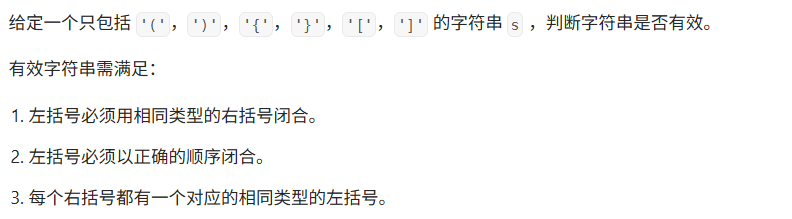
思路:因为必须保证对称性,因此栈比较合适,只要每次反括号都能与前面对称,就是有效的。
注意:
- 如果每次到反括号时去判断,会多一步判断,时间很浪费。直接第一个括号时就push对应反括号,后面比较就很快。
- 最后还要判断stack是否为空,因为可能存在有前括号没有反括号的情况。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| class Solution {
public boolean isValid(String s) {
Stack<Character> stack = new Stack<>();
for(char c : s.toCharArray()) {
if(c == '{') stack.push('}');
else if(c == '(') stack.push(')');
else if(c == '[') stack.push(']');
else {
if(stack.isEmpty() || stack.pop() != c) return false;
}
}
return stack.isEmpty();
}
}
|
滑动窗口
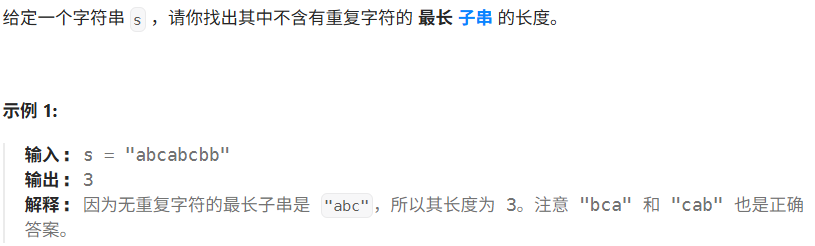
思路:使用一个空间记录当前已走的字符和下标。每走一步判断该字符是否在当前最长字符串中重复。重复则更新当前长度。
注意:
- 即使字符重复也可能不在当前认为的最长字符中(此时表示可以增加当前最长字符串长度),因为其可能在某个重复字符被连带认为不是最长的了。
二叉树
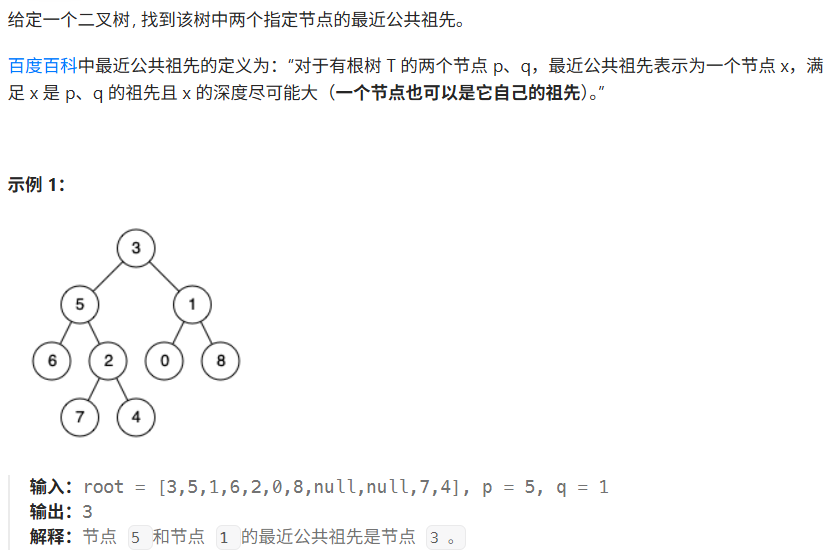
思路:判定条件即为,该节点左右子树或本身是否包含p、q。有题目求最近就可以考虑深度优先。
注意:
- 注意返回值的设定;
- 注意p、q的判定 与 左右子树递归 的时机判断。
- 两种方式:
- 直接返回root = q或q的root;层层返回,两种情况:
- pq在不同子树,此时判断是否左右子树返回都不为null即找到;
- pq某一节点为公共祖先,但只要判断root == p或q就会返回root,会被覆盖为公共祖先。
- 返回左右子树是否存在pq,此时需要注意判断pq是否为公共祖先。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| class Solution {
TreeNode res = null;
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {
if(root == null) return null;
if(root == p || root == q) return root;
TreeNode left = lowestCommonAncestor(root.left, p, q);
TreeNode right = lowestCommonAncestor(root.right, p, q);
if(left == null && right == null) return null;
if(left == null) return right;
if(right == null) return left;
return root;
}
}
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| class Solution {
TreeNode res = null;
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {
contains(root, p, q);
return res;
}
boolean contains(TreeNode root, TreeNode p, TreeNode q){
if(root == null) return false;
boolean leftContains = contains(root.left, p, q);
boolean rightContains = contains(root.right, p, q);
if((leftContains && rightContains) || ((root == q || root == p) && (leftContains || rightContains))) res = root;
return ((root == q || root == p) || leftContains || rightContains);
}
}
|
二分查找
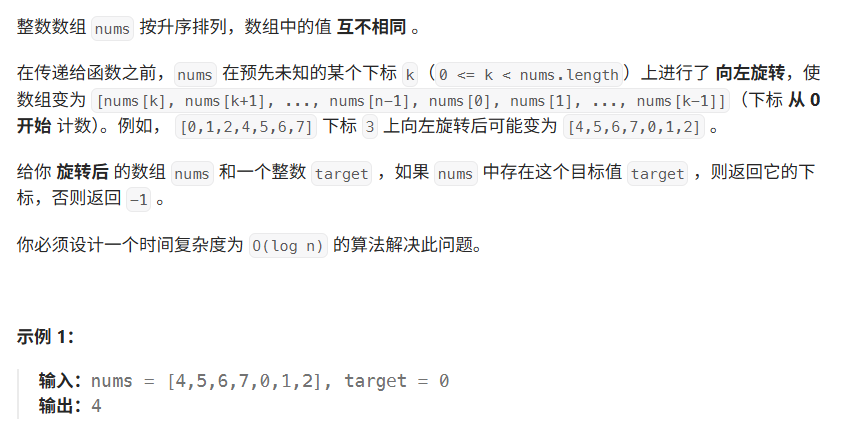
思路:利用有序特性,边二分边判断左右子区间是否有序,只要有序则判断是否在有序区间(利用有序特性),否则一直二分。注意不能直接左右子区间,不利用有序性,这将退化为On。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
| class Solution {
public int search(int[] nums, int target) {
int left = 0, right = nums.length - 1;
if(right < 0) return -1;
if(right == 0) return target == nums[0] ? 0 : -1;
while (left <= right) {
int mid = left + (right - left) / 2;
if (nums[mid] == target)
return mid;
if (nums[left] <= nums[mid]) {
if (nums[left] <= target && target < nums[mid]) {
right = mid - 1;
} else {
left = mid + 1;
}
} else {
if (nums[mid] < target && target <= nums[right]) {
left = mid + 1;
} else {
right = mid - 1;
}
}
}
return -1;
}
}
|
链表
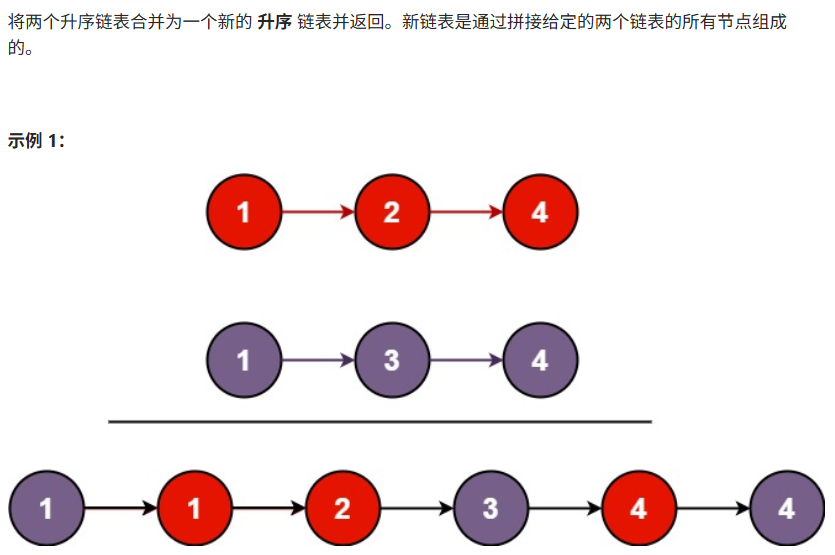
思路:两个指针记录两个链表下一个要比较的节点,依次递推即可。
注意:
- 直接创建dummy和移动的tail即可,因为不会新建节点,因此空间为O1。
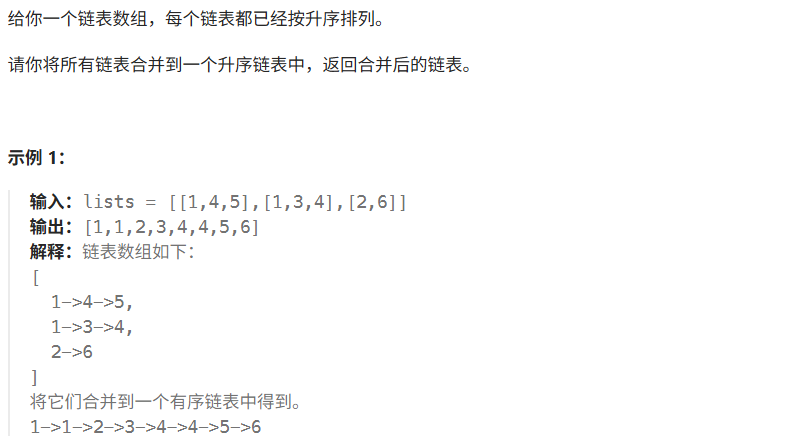
思路:基础的两个升序链表合并(两个tmpNode记录两链表当前比较的Node),由于是多个合并可以考虑lists的0到length-1的个子区间合并,即分治算法。
注意:
- 分治算法的区间mid = (left + right) >> 1,(left, mid),(mid + 1, right)
- 分治算法left > right最好也判断,因为初始条件可能length为0,这会导致区间为(0, -1)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
| class Solution {
public ListNode mergeKLists(ListNode[] lists) {
return divideMerge(lists, 0, lists.length - 1);
}
private ListNode divideMerge(ListNode[] lists, int left, int right) {
if(left == right) return lists[left];
if(left > right) return null;
int mid = (left + right) >> 1;
ListNode leftList = divideMerge(lists, left, mid);
ListNode rightList = divideMerge(lists, mid + 1, right);
return mergeTwoLists(leftList, rightList);
}
private ListNode mergeTwoLists(ListNode first, ListNode second) {
if(first == null || second == null) return first == null ? second : first;
ListNode res = new ListNode(0);
ListNode aPtr = first, bPtr = second, tail = res;
while(aPtr != null && bPtr != null) {
if(aPtr.val >= bPtr.val) {
tail.next = bPtr;
bPtr = bPtr.next;
} else {
tail.next = aPtr;
aPtr = aPtr.next;
}
tail = tail.next;
}
tail.next = aPtr == null ? bPtr : aPtr;
return res.next;
}
}
|
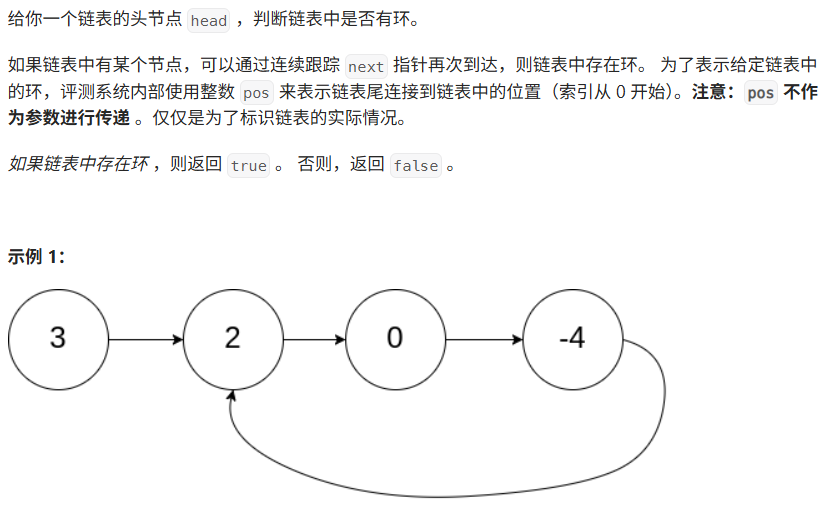
思路:使用两个指针,slow和fast,使之每次各移动1、2步长;只要有换,由于步长相差一,则一定会在环中节点相遇。
注意:
- 代码细节:先移动,再判断,因为while已经判断过了,否则代码一致性和逻辑性存在问题。
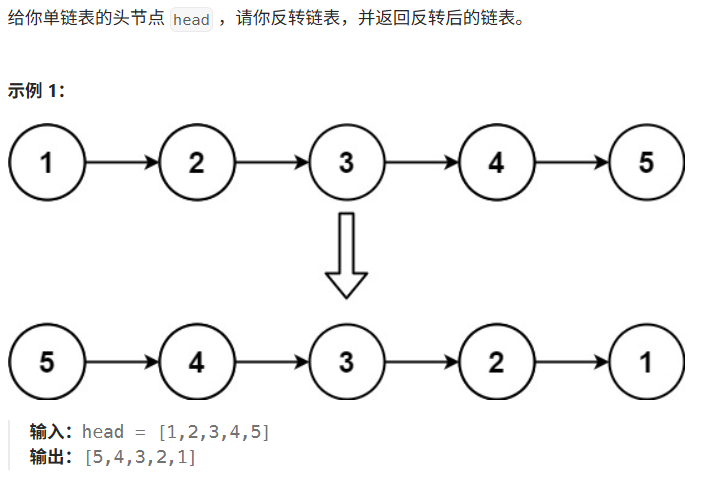
思路:
- 记录preNode 和 curNode,直到curNode为null,返回preNode,但这种为正向,导致会记录curNode下一个Node,nextNode;
- 原地翻转:反向更新,递归找到最后一个Node,层层返回,并每层做curNode.next.next指向curNode完成翻转。
注意:
- 翻转后将curNode记录为null,保证链表最终正确性。
贪心
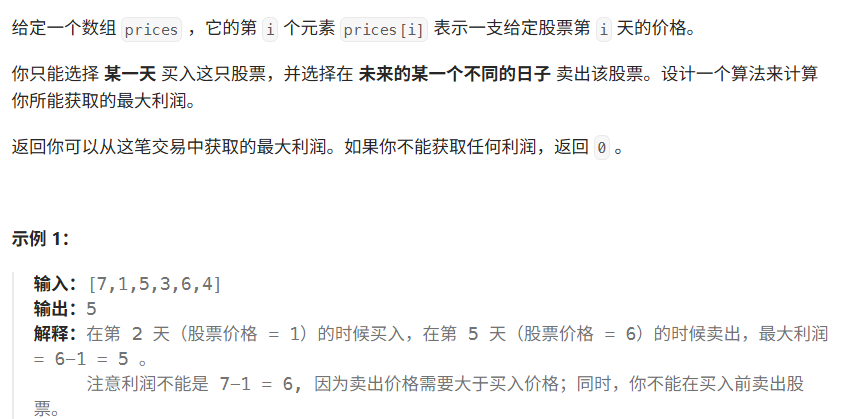
思路:由于题目数组与最后要求为 从左至右 ,因此有一个点可以确定,最后数字买入一定在卖出左边且是处于卖出天数之前的最小价格。因此可得思路:右边作为遍历i,每次遍历时更新其左侧的最小价格,再更新最大利润即可。
1
2
3
4
5
6
7
8
9
10
11
12
| class Solution {
public int maxProfit(int[] prices) {
int max = 0, min = prices[0];
for(int price : prices) {
min = Math.min(min, price);
max = Math.max(max, price - min);
}
return max;
}
}
|
动态规划DP
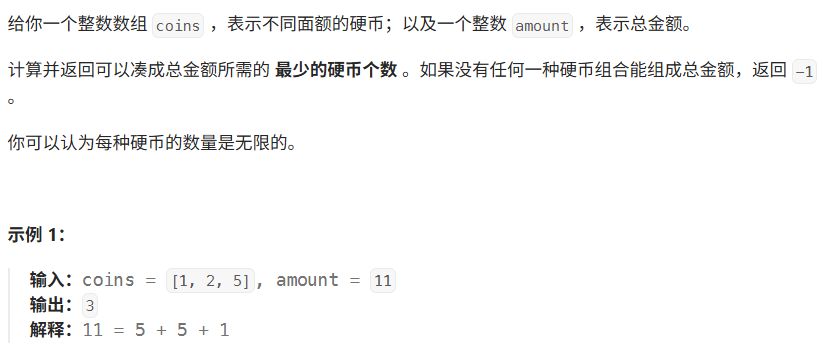
思路:从0开始计算每个数额(0 - amount)的最少的硬币组合方式,直到amount。
注意:
- dp[0]作为起始应该是0而不是-1;否则一是后续不可达,二是不符合题意。
- 在更新dp数组时,因为考虑是最小值,而数组中的默认值是0,因此要分开讨论,否则最小值全为0;
- dp数组长度应该初始化为amount + 1;否则无法计算到amount。
图论
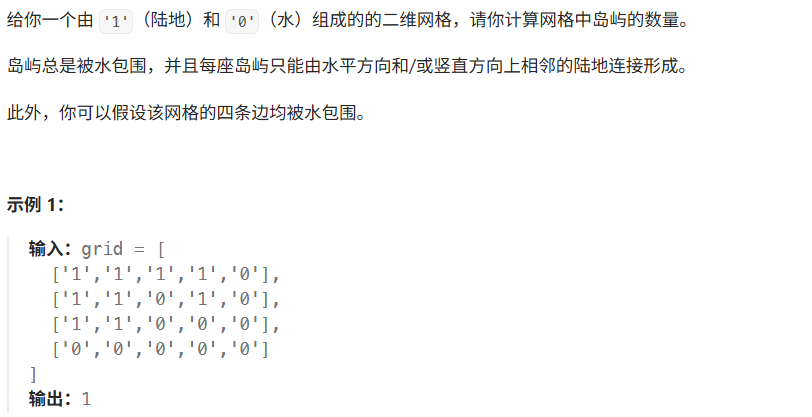
思路:扫描二维数组,只要走到1的岛屿,就dfs找出同一个岛屿的所有格子,并将1置为0避免重复找。
注意:
- dfs中需要判断i,j是否超出二维数组边界,以及要跳过为0的格子。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
| class Solution {
int line = 0;
int colum = 0;
char[][] grid = null;
private void dfs(int i, int j) {
if(i < 0 || i >= line || j < 0 || j >= colum || grid[i][j] == '0') return ;
grid[i][j] = '0';
dfs(i - 1, j);
dfs(i + 1, j);
dfs(i, j + 1);
dfs(i, j - 1);
}
public int numIslands(char[][] grid) {
line = grid.length;
colum = grid[0].length;
this.grid = grid;
int res = 0;
for(int i = 0; i < line; i++) {
for(int j = 0; j < colum; j++) {
if(grid[i][j] == '0') continue;
else {
dfs(i, j);
res++;
}
}
}
return res;
}
}
|
 lzz's Blog